作者 ImageTranslate · 編輯準則
如何翻譯圖片中的文字,不必重新打字
直接解答
當空間位置、箭頭、圖說與視覺結構對理解至關重要時,自動化且保留版面的圖片翻譯是最佳選擇。 如果版面不重要,只需要原始文字字串做分析,那麼先用 OCR 擷取文字再翻譯會更合適。
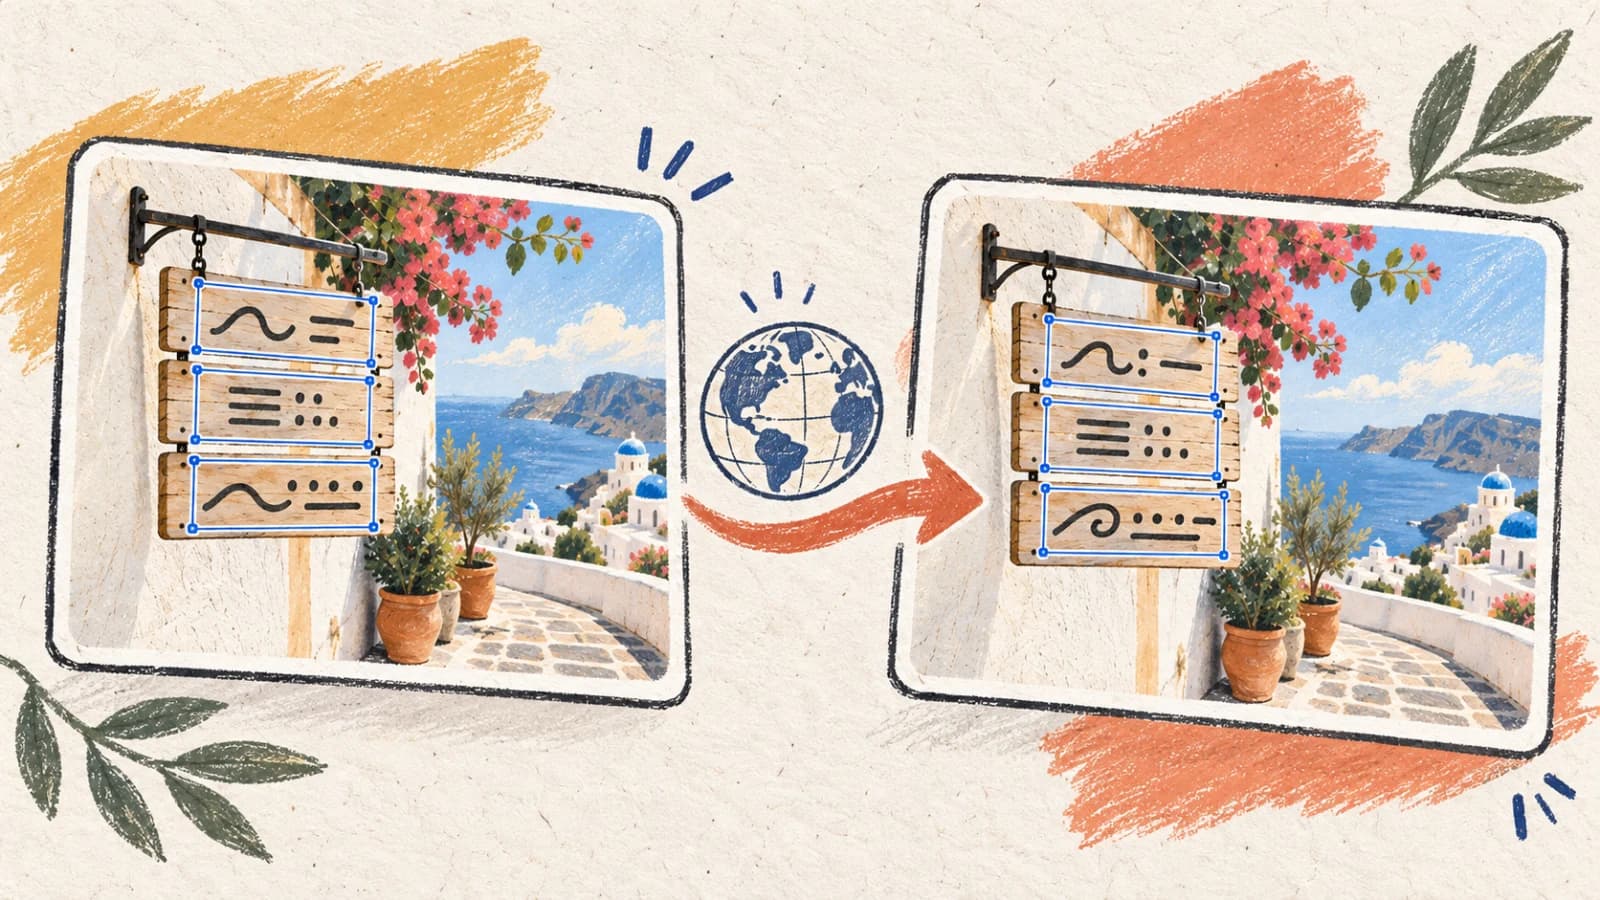
翻譯嵌在圖片裡的文字,本質上是一個複雜的空間問題。不同於含有可選取文字字串的文件,圖片是以原始的色彩像素網格來儲存文字。你無法把螢幕擷圖、系統示意圖、資訊圖表、產品包裝標籤或技術藍圖中的文字複製貼上到一般翻譯引擎,而不失去空間脈絡與版面配置。
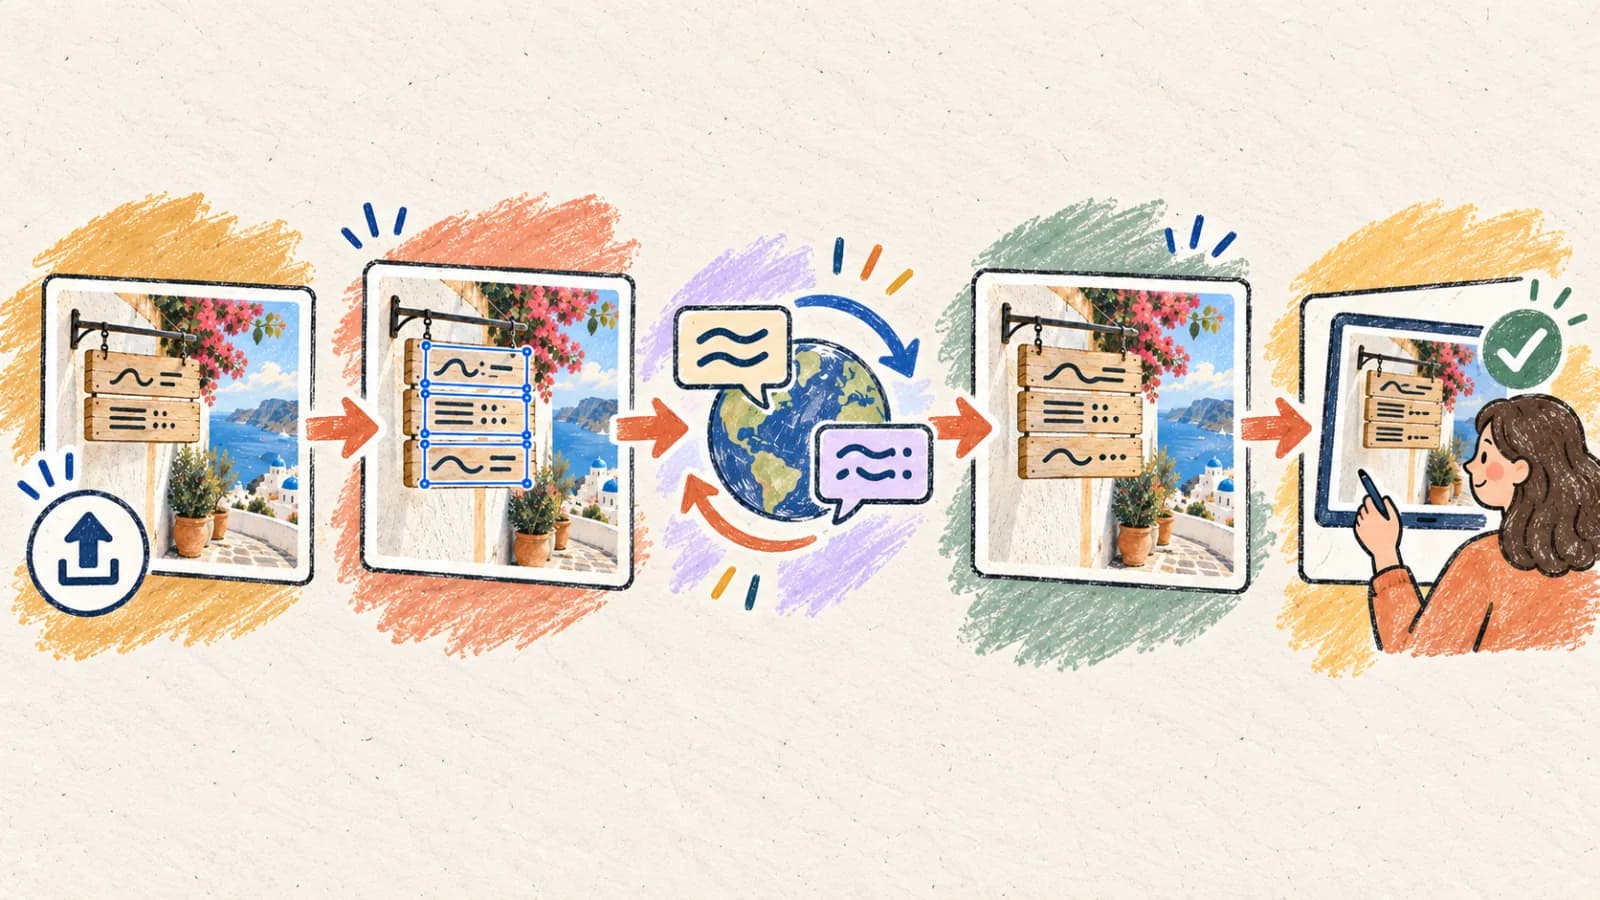
傳統做法是手動重新排版:抹掉原始文字、把背景補起來(影像修補),再用手繪方式加上新的在地化文字方塊。現代保留版面的圖片翻譯器則協調三套系統,把整條流程自動化:以光學字元辨識(OCR)做空間文字偵測、以大型語言模型(LLM)做具上下文感知的機器翻譯,再以視覺修補演算法替換文字而不留下痕跡。
本篇指南會說明圖片翻譯的技術機制、比較自動化與手動流程、詳述行動裝置拍攝的最佳化步驟,並提供一份嚴謹的品管檢查清單,供專業製作環境使用。
重點整理
- 當空間位置、箭頭、圖說與視覺結構對理解至關重要時,自動化且保留版面的圖片翻譯是最佳選擇。
- 如果版面不重要,只需要原始文字字串做分析,那麼先用 OCR 擷取文字再翻譯會更合適。
- 高解析度的來源檔案是關鍵;通訊軟體經過度壓縮的 JPEG 會讓細筆畫模糊,拉低 OCR 的信心分數。
- 文字擴張是版面配置的一大挑戰;譯文(特別是從英文譯成德文或西班牙文)往往需要主動調整字距、行距與邊界。
- 務必把品牌名稱、系統 ID 與型號鎖進術語詞彙表,避免 AI 引擎把它們也翻掉。
為什麼圖片中的文字不好翻譯?
圖片翻譯器必須同時解決數個互相牽動的電腦視覺與語言挑戰。流程中任何一環出錯,都會讓最終的視覺成品打折。
文字是像素網格,不是字元字串
JPEG 或 PNG 檔案中沒有語意文字圖層。引擎必須執行 OCR 演算法來切分行、定位文字區塊邊界並重建閱讀順序。特殊字型、陰影與雜亂的背景都會引入雜訊,降低 OCR 擷取的可信度。
透視變形與旋轉扭曲
用手機拍攝標示、標籤或手冊時,常出現透視傾斜與幾何扭曲。彎曲表面和光線變化會產生陰影,導致字元切割器誤判字母,除非先校正檔案。
目標語言的文字擴張與收縮
譯文所需空間會隨語言和措辭改變。請檢查實際輸出,並視需要調整字級、間距或頁邊距。
抹除原始文字會留下視覺疤痕
替換文字必須先抹掉原有像素。直接在舊文字上蓋一個純色色塊看起來很粗糙。翻譯引擎必須執行修補演算法,分析周圍的材質與漸層,動態重建背景,再疊上譯文字串。
詞彙碰撞與品牌稀釋
技術示意圖與產品圖中,在地化術語往往和 SKU 編號、URL、品牌名稱等不可翻譯的單位並存。天真的 AI 翻譯器會照字面翻掉專有名詞(例如把 Apple 或 Red Hat 這類品牌當成普通詞彙翻譯),破壞技術正確性。
翻譯圖片文字的四種方法
請依據所需的輸出保真度、素材重複使用性,以及翻譯錯誤的代價來選擇工作流程。
方法 1:使用自動化且保留版面的 AI 圖片翻譯器
螢幕擷圖、UI 模擬圖、資訊圖表、示意圖、行銷橫幅與產品型錄,且視覺結構必須維持原樣的情況。
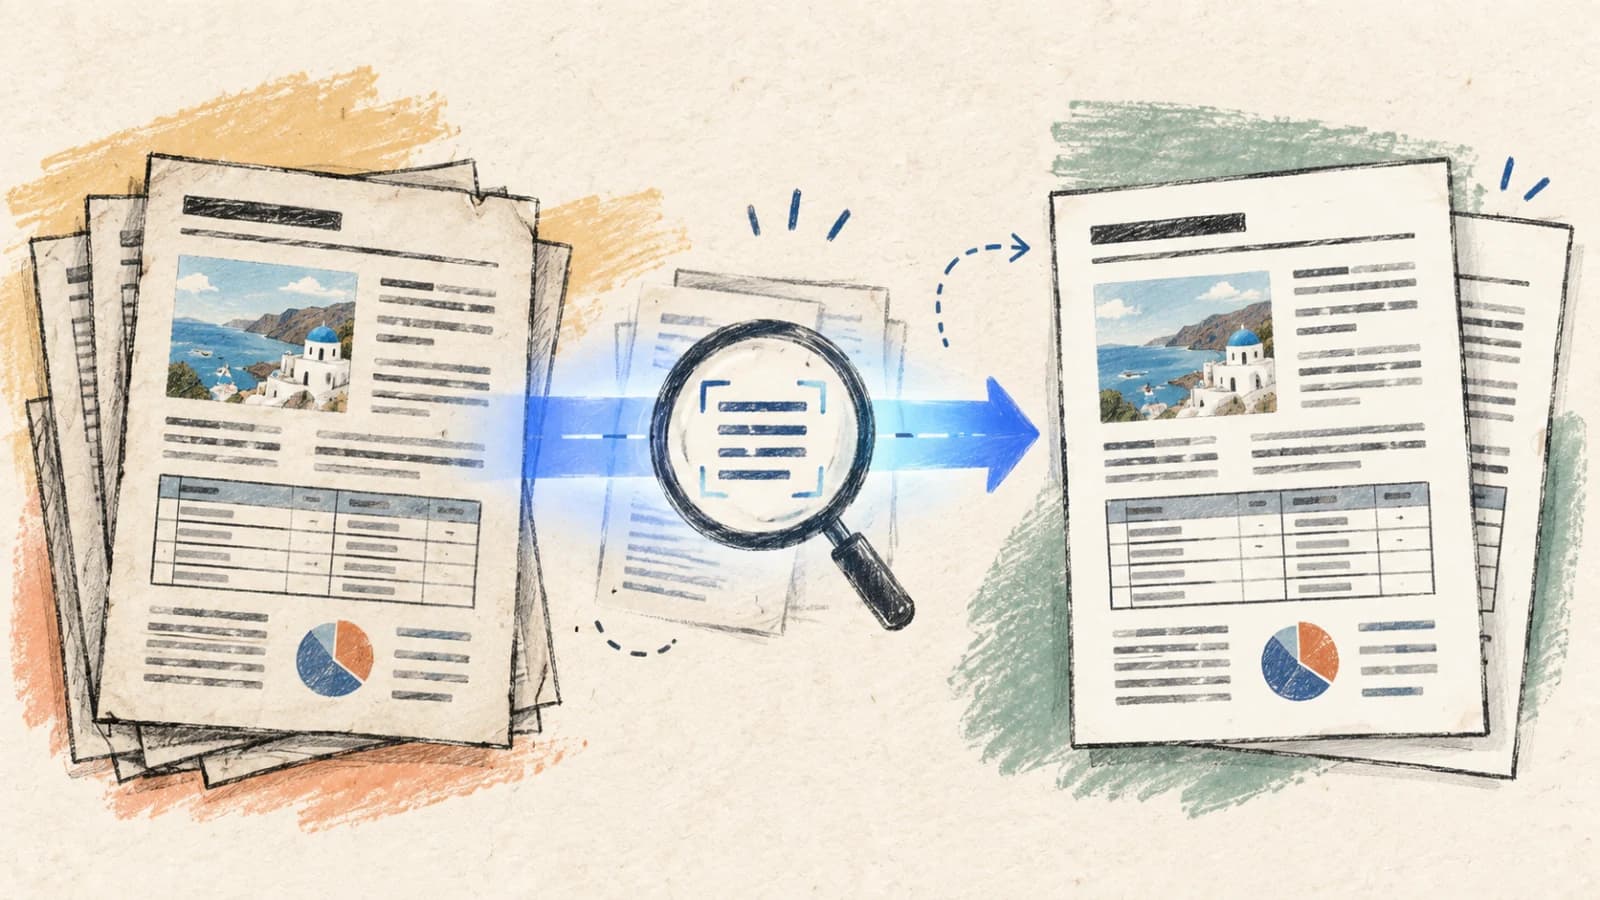
這是最有效率也最容易擴充的方法。它在單一流程中處理 OCR 區塊擷取、背景材質修補、翻譯與在地化排版。引擎會分析原始文字的邊界框與顏色,使用相近的字型家族和相同的角度來繪製譯文。
自動化引擎雖然能達到相當高的視覺保真度,但含有重疊元素或低對比文字的複雜版面仍需人工確認。請務必以 100% 縮放檢查產出的素材,確認文字沒有被裁切,且數字、小數點與符號維持不變。
操作步驟
- 1把解析度最高的來源圖片(建議 PNG 或無損 WebP)直接上傳到圖片翻譯器。
- 2選擇指定的目標語言,並挑選符合預算與領域需求的翻譯模型。
- 3設定翻譯指引或術語詞彙表(例如品牌名詞、縮寫),避免模型產生幻覺。
- 4執行翻譯流程,並將產出的圖片與原始檔案並排比對。
- 5匯出最終圖片素材前,先確認關鍵的空間對齊與文字換行。
- 先裁掉黑邊或通訊軟體介面,不要把運算資源浪費在沒有內容的元素上。
- 不要上傳放大處理過的低解析度圖片;請改用原始向量檔或原始擷圖。
方法 2:先用 OCR 擷取文字,再翻譯文字本身
研究、文件分析、資料輸入與發票處理,只需要文字意義、版面無關緊要的情況。
這個兩段式流程把光學字元擷取與翻譯分開。先對圖片執行 OCR 解析器取得純文字,校對輸出以修正辨識錯誤,再把清理乾淨的文字送進 AI 文字翻譯引擎。
這種做法彈性很高,也避開了排版引擎的限制,但會完全失去原始的視覺階層。在多欄文件、方塊圖或表格中,OCR 引擎可能把水平文字行分組錯誤,導致句子錯置、翻譯的上下文被破壞。
操作步驟
- 1對來源圖片執行 OCR 掃描,或使用行動裝置原生的文字選取 API。
- 2檢查原始文字輸出是否有誤判字元,特別是數字、符號與小數點。
- 3把乾淨的字串貼進具上下文感知的 AI 文字翻譯器。
- 4逐段檢視譯文,並對照來源圖片釐清上下文。
- 5把定稿譯文匯出為純文字、Markdown 或文件格式。
方法 3:先翻譯文字內容,再手動更新設計檔案
高風險的品牌活動、產品包裝與重要範本檔案,且你手上有分層設計檔(Canva、Figma、PSD)的情況。
對於必須達到像素級行銷標準的品牌素材,自動化只應用來產生翻譯草稿。先讓圖片跑一次自動翻譯,快速取得空間參考草稿;接著匯出核准後的譯文,手動貼回你的分層設計環境。
這種做法比較費時,但能換來最大的字型控制權。設計師可以手動調整字距、行距、字間與文字邊界,讓版面完美平衡,使所有在地化版本都符合品牌嚴謹的視覺規範。
操作步驟
- 1用圖片翻譯器產生自動化的視覺翻譯草稿,作為擺放位置的參考。
- 2整理一份結構化的在地化對照表,把所有來源字串配對到核准的譯文。
- 3開啟分層設計檔(例如 Figma 或 Photoshop),鎖定各個文字圖層。
- 4把原始文字換成在地化字串,並調整字級與行高以符合容器。
- 5匯出最終的高保真素材,並與來源設計及參考草稿做一次對照檢視。
方法 4:導入人工監督的 human-in-the-loop 流程
受法規管制的包裝、醫療指示、技術示意圖、帳單圖表,以及高價值的對外素材。
AI 引擎能產生相當流暢的初稿,但在高風險素材上仍無法取代專業譯者。在 human-in-the-loop 流程中,先由自動翻譯引擎產生在地化的版面初稿,再由母語語言專家檢視譯圖,確認術語正確且語意沒有偏移。
語言專家必須在視覺版面中檢視譯文,而不是在獨立的試算表裡。依賴版面的上下文(例如指向某個元件的箭頭)一旦脫離情境就很容易遺失,進而導致嚴重錯誤。
操作步驟
- 1用自動化 AI 圖片翻譯器產生在地化版面草稿。
- 2把原始圖與譯圖一併交給母語審校人員進行查核。
- 3找出並修正誤譯、拗口語句,以及文字被裁切的結構問題。
- 4把修正後的字串重新繪製到圖片畫布中,確保排版對齊正確。
- 5將核准的視覺譯圖歸檔,並鎖定術語定義供日後更新使用。
如何在 iOS 或 Android 上翻譯圖片
用行動裝置翻譯圖片,在處理旅遊標示、紙本文件、菜單與臨時擷圖時非常方便。由於行動裝置螢幕較小,最主要的操作挑戰是維持可讀性並避免介面裁切。
若要得到專業級成果,請務必用高品質的相機設定拍攝。如果圖片是透過通訊軟體分享的,請以未壓縮的文件形式傳送,不要用一般壓縮照片,以免字型筆畫變形。
- 1在行動瀏覽器中開啟圖片翻譯器。
- 2從相簿上傳目標圖片,或從檔案中挑選結構化文件。
- 3選擇目標語言並啟動自動翻譯引擎。
- 4放大檢視小字、技術標籤、註腳與邊緣對齊。
- 5下載並儲存高解析度的譯圖,確認清晰度與可讀性。
哪一種圖片翻譯方法適合你的任務?
把你的翻譯需求對應到合適的流程,在自動化處理的速度與手動設計調整的字型精準度之間取得平衡。
| 使用情境 | 最佳選擇 | 難點 |
|---|---|---|
| 需要快速在地化螢幕擷圖、UI 版面或資訊圖表 | 保留版面的圖片翻譯器 | 在單一且快速的流程中自動完成 OCR、背景修補與排版。 |
| 分析螢幕擷圖或發票內容,沒有版面需求 | OCR 擷取 + 文字翻譯 | 讓純文字校對變單純,也省掉不必要的設計重建。 |
| 製作高規格行銷活動,且手上有分層設計檔 | 草稿翻譯 + Figma/PSD 重新排版 | 讓設計師完全掌控品牌字型、字距與樣式。 |
| 在地化安全標示、醫療包裝或法律文件 | AI 版面草稿 + 認證人工審校 | 人工複核有助於檢查術語、含義和版面,但不能保證完全無誤或符合法規。重要材料請由具備相關資格的專業人員審核。 |
獲得更好結果的技巧
消除透視傾斜
拍攝實體標示或文件時,請與表面平行拍攝。透視傾斜會讓字形變形,大幅拉低 OCR 的可信度。同時裁掉沒有用的背景。
保護專有名詞與 SKU 字串
用詞彙表鎖定品牌名稱、技術型號、URL 與變數。AI 模型不應該翻譯或在地化這些技術識別資料。
為目標語言的擴張預留空間
譯文所需空間會隨語言和措辭改變。請檢查實際輸出,並視需要調整字級、間距或頁邊距。
檢查數字格式與標記
翻譯不等於在地化。請確認小數點(逗號或句號)、日期格式(MM/DD 或 DD/MM)與貨幣符號符合當地規格。
使用原始來源檔,不要用擷圖
避免擷圖的擷圖。每一次壓縮與重新存檔,都會在字元周圍產生視覺雜訊,干擾現代 OCR 的切分引擎。
確保足夠的對比門檻
疊在複雜照片背景或色彩漸層上的文字不易偵測。可先調整對比或轉成灰階,協助 OCR 掃描。
以 100% 縮放檢查邊界
靠近邊界的小字註腳、圖說與標籤,在版面重建階段特別容易被裁掉。發佈前請務必完整放大檢查一遍。
建立可重複使用的翻譯詞彙表
保留關鍵片語與產品特色的在地化詞彙表。重複使用已核准的術語,可確保多通路一致性,並縮短後續專案的審校時間。
常見問題
保留版面的圖片翻譯器底層是怎麼運作的?
它執行多階段流程:首先由 OCR 模型切分影像、找出文字區塊並偵測座標;接著由視覺修補模型把原始文字從背景清除;再由 LLM 翻譯擷取出的字串;最後由網頁畫布引擎以相符的字級、顏色與角度,把譯文繪製回原位。
支援哪些圖片檔案格式?
翻譯流程完整支援 PNG、JPEG 與 WebP 等標準圖片格式。為了取得最佳 OCR 準確度並將壓縮雜訊降到最低,強烈建議使用無損的 PNG。
翻譯器能保留來源圖片中的企業字型嗎?
自動化引擎會分析字元結構,從龐大的開源與系統字型庫中選出最相近的替代字型。若使用專屬的企業品牌字型,建議先產生自動草稿,再於分層的 Figma 或 PSD 設計檔中手動替換文字。
為什麼 OCR 引擎偶爾會漏掉極小或特殊造型的文字區塊?
OCR 準確度取決於圖片解析度與字元對比。過於花俏的草書字型、模糊的字、低對比(例如白底上的淺灰字),以及旋轉角度特殊的文字,都可能導致偵測失敗。預先裁切或提高來源圖片的對比可以改善這個問題。
在手機上該怎麼處理翻譯?
開啟瀏覽器版的圖片翻譯器,直接從相簿上傳照片或擷圖,讓系統自動翻譯,再用雙指縮放檢查技術細節,最後下載高品質的輸出。
AI 圖片翻譯用於敏感的商業文件安全嗎?
是的,我們的服務採用企業級安全協定。我們不會使用客戶資料或上傳的文件素材來訓練 AI 模型,確保你的機密示意圖與私人文件維持保密。
傳遞在地化的視覺衝擊,而不只是文字
高品質的圖片翻譯,彌合了文字在地化與視覺設計之間的落差。若只是要快速擷取資訊,OCR 轉文字非常有效率。但當你的最終交付物是一張用來引導、銷售或說明的圖片時,就需要保留版面的翻譯器。
理解 OCR 的邊界、妥善處理文字擴張並運用自訂詞彙表,你就能擴充在地化視覺素材的產能,同時不犧牲設計的技術完整性。