作者 ImageTranslate · 編輯準則
如何用 AI 準確翻譯長篇文字
直接解答
請依照語意上的邏輯段落(例如章節或子標題)來翻譯,不要用任意的字數上限來切分檔案。 為品牌名稱、技術術語與縮寫建立雙語術語詞彙表,讓各段落保持一致。
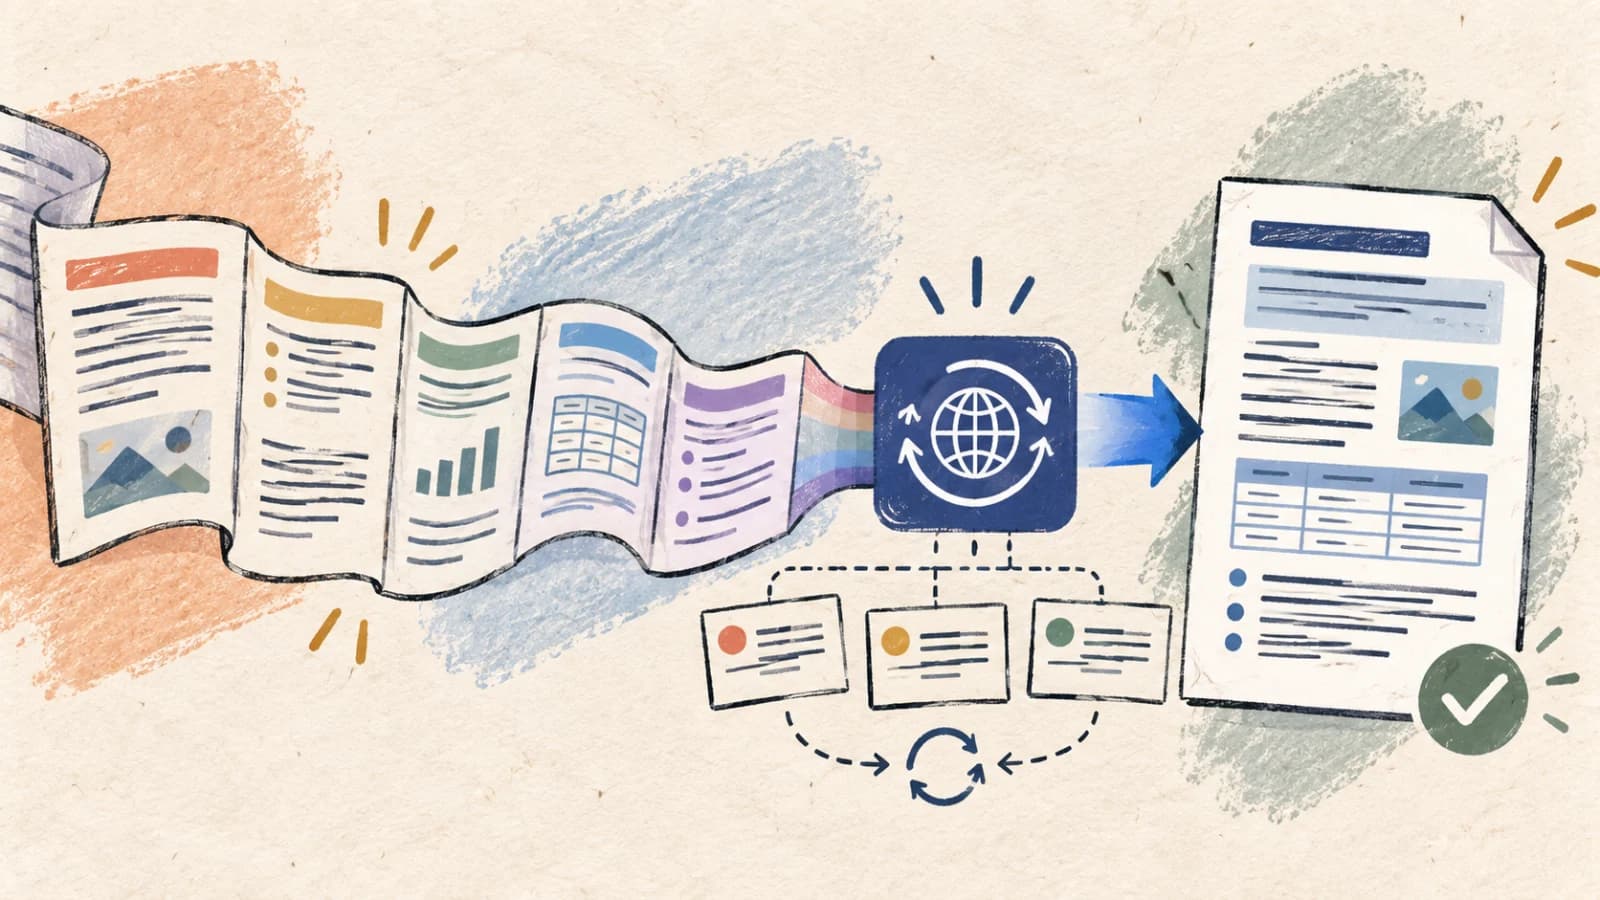
用 AI 翻譯長篇文字會帶來一個重大挑戰:如何在數十頁的內容中維持一致性。現代 LLM 確實能在幾秒內把單一段落翻得相當流暢,但翻譯長篇報告、書籍或技術手冊時,往往出現術語偏移、上下文連結遺失與語氣不一致的問題。
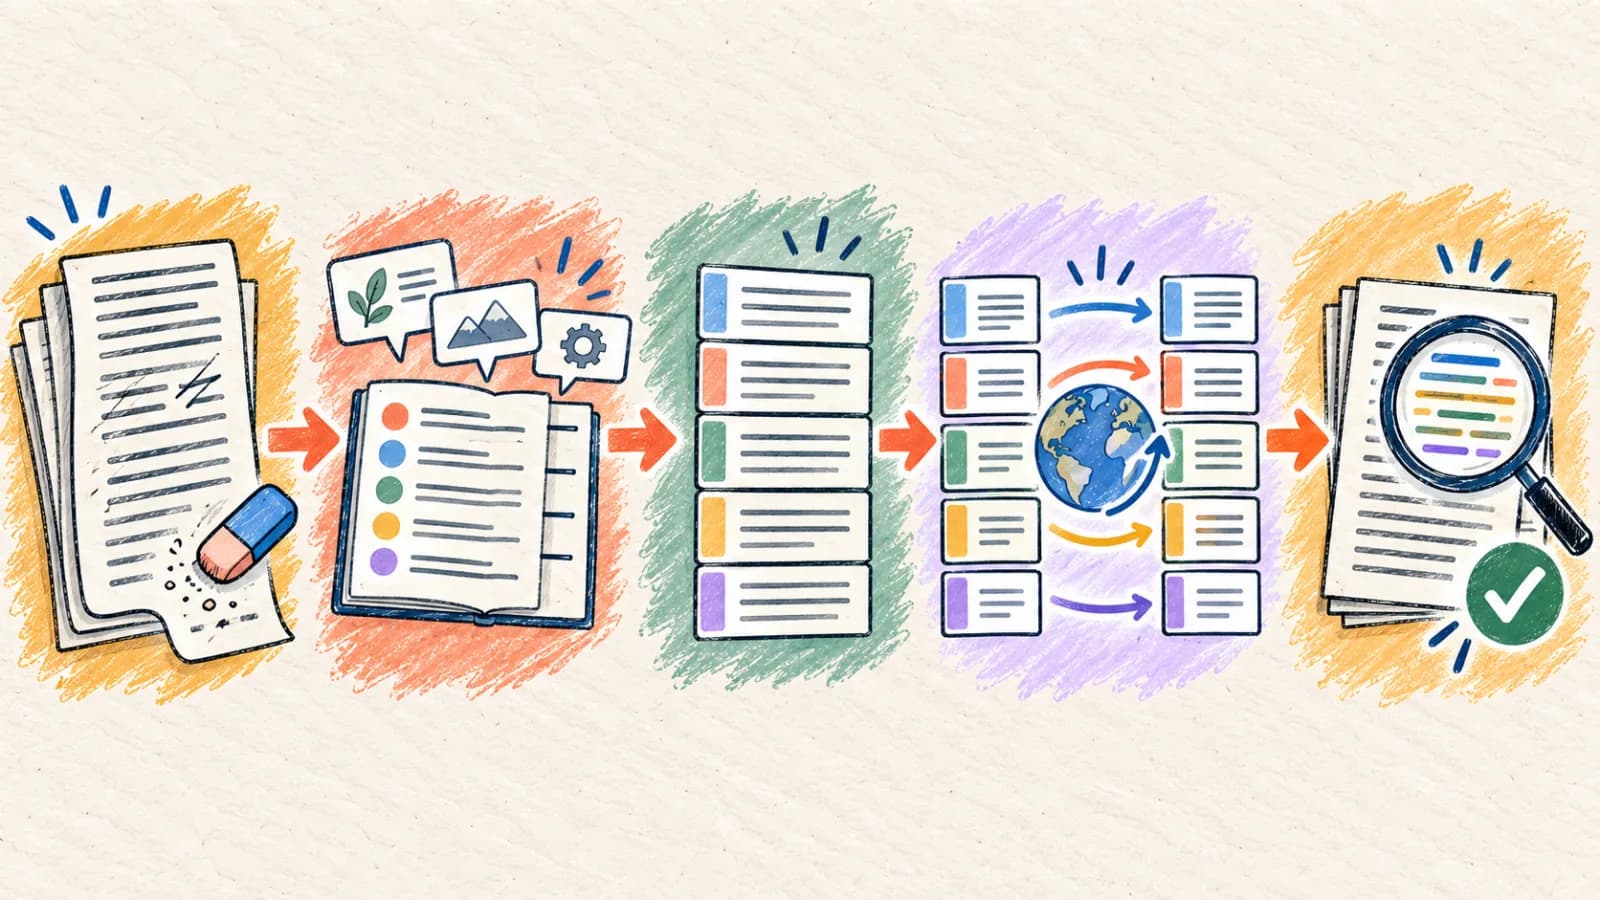
舉例來說,某個在前言中定義過的術語,到了後面章節可能譯成另一個詞;或是在各段被獨立翻譯時,代名詞失去了原本指涉的對象。高品質的長篇翻譯需要一套結構化流程:準備來源、定義術語詞彙表、管理語意切分邊界,並執行最後的一致性檢查。
本篇完整指南說明為什麼長篇 AI 翻譯會失準、列出四種結構化的翻譯流程、詳述行動裝置上的最佳化步驟,並提供術語與風格的檢查清單。
重點整理
- 請依照語意上的邏輯段落(例如章節或子標題)來翻譯,不要用任意的字數上限來切分檔案。
- 為品牌名稱、技術術語與縮寫建立雙語術語詞彙表,讓各段落保持一致。
- 短篇段落用互動式文字翻譯器;需要保留檔案格式與樣式時,改用結構化文件翻譯器。
- 譯文分兩道獨立關卡查核:一道檢查技術數字與否定語,另一道檢查可讀性與風格。
- 最後再單獨讀一遍譯文、不看原文,確認語句在目標語言中讀起來自然通順。
為什麼長篇 AI 翻譯會失準?
長文件中的句子之間存在複雜的語意依賴網絡。一旦這些依賴關係在處理過程中被切斷,翻譯品質就會下降。
跨段落的上下文碎裂
某個代名詞、縮寫或產品暱稱,可能在好幾頁之前就被定義過。如果後面的章節被獨立處理,AI 模型就缺少這層上下文,只能選一個看似合理卻不正確的譯法。
術語與行話偏移
許多技術詞在目標語言中有多個合法譯法。沒有鎖定詞彙表,AI 引擎就會在不同段落用不同的詞,讓讀者困惑,也削弱品牌一致性。
天真的字數切分
基本的翻譯 API 會嚴格按照字數上限切分長檔。這會把句子和段落切成兩半,破壞語言上下文,產生破碎而無法閱讀的譯文。
來源文件的歧義擴散
來源文件中語意不清的措辭、不一致的標點、未定義的縮寫與文法錯誤,都會讓翻譯模型產生幻覺,或選錯解讀方式。
誤翻預留位置
長篇技術文件常含有系統變數、HTML 標籤或程式碼預留位置(例如 `{userName}`)。天真的翻譯模型會把這些字串也翻掉,破壞後續的程式整合。
準確翻譯長篇文字的四種方法
請依據文件大小、格式需求與所需的精準度,選擇適合的長篇文字翻譯方式。
方法 1:以語意段落切分進行互動式翻譯
文章、隨筆、客戶信件與文案草稿,需要主動且即時編修的情況。
這是一套彈性極高、需要親自動手的流程。不要把整份大型文件一次丟進翻譯器,而是依照邏輯段落,互動式地逐段翻譯。這讓你能逐區塊確認術語、修飾句子結構並調整語氣。
這種方法的掌控度極佳,但相當耗費人力,最適合幾千字以內的文件。遇到更長的手冊或書籍,手動切分就顯得沒有效率,應該改用自動化的文件翻譯流程。
操作步驟
- 1開啟文字翻譯器並設定目標語言。
- 2把長文切成邏輯上完整的語意段落(不要切斷句子)。
- 3翻譯第一段,並為後續區塊定下語氣(例如專業、說明式)。
- 4確認關鍵術語在各段落之間翻譯一致。
- 5匯出彙整完成、修飾妥當的譯文。
- 避免使用會自動重新整理頁面的工具,以免遺失翻譯的工作階段記錄。
- 另外開一份草稿檔案,用來彙整已核准的譯文段。
方法 2:使用具 AST 感知的文件翻譯器
長篇 DOCX 手冊、電子書、Markdown 技術文件與結構化政策檔案,必須保留格式的情況。
當你的長檔附有複雜樣式(標題、巢狀表格、清單與連結)時,手動複製貼上並不實際。這時請直接把檔案交給具 AST 感知的文件翻譯器處理。
引擎會剖析文件結構、擷取出文字層,用滑動上下文視窗處理以維持術語一致,再把譯文寫回。這能讓你的格式與樣式完整保留。
操作步驟
- 1清理來源文件,解決所有追蹤修訂與註解。
- 2把 DOCX 或 Markdown 檔案上傳到文件翻譯器。
- 3選擇目標語言並匯入你的自訂術語詞彙表。
- 4執行翻譯,下載保留樣式且可編輯的在地化文件。
- 5檢視版面,調整表格欄寬與分頁位置以容納擴張的文字。
方法 3:把自訂術語詞彙表注入翻譯流程
技術規格、法律合約與在地化行銷文案,術語必須嚴格統一的情況。
要讓長文件達到絕對一致的用語,你必須把術語管理與翻譯模型拆開。先在來源檔案中找出關鍵的產業術語、品牌名稱與縮寫,建立一份雙語詞彙對照表。
處理文件時,把這份詞彙表匯入翻譯引擎。系統會自動提示翻譯模型使用你核准的術語,消除術語偏移,確保專業的一致性。
操作步驟
- 1檢視來源文件,找出關鍵技術術語與品牌縮寫。
- 2建立雙語詞彙表,把來源術語對應到核准的譯法。
- 3處理檔案前,先把詞彙表上傳到我們的翻譯入口網站。
- 4執行文件翻譯,並確認引擎確實套用了你的詞彙對應。
- 5儲存詞彙表,供日後的在地化更新重複使用。
方法 4:導入雙關卡專業審校流程
高風險出版品、企業年報、財務查核與對外的產品文件。
人工複核有助於檢查術語、含義和版面,但不能保證完全無誤或符合法規。重要材料請由具備相關資格的專業人員審核。
第一關聚焦翻譯準確度,確認技術術語、數字與否定敘述對應無誤。第二關聚焦風格與可讀性,確保文字讀起來自然,並符合品牌的語氣指引。
操作步驟
- 1用我們的自動化文件翻譯器產生初步譯稿。
- 2請母語譯者執行技術查核,確認數字、名稱與詞彙表術語。
- 3請文字編輯執行第二關,修飾風格、語氣與可讀性。
- 4把所有修正套用到你的在地化主檔案。
- 5將核准的文件歸檔,並更新你的翻譯記憶資料庫。
如何在行動裝置上翻譯長篇文字
在行動裝置上檢視與翻譯長篇文字,對商務出差來說非常方便。請改用可在雲端直接處理檔案的回應式瀏覽器翻譯工具,不必開啟笨重的桌面應用程式。
在手機螢幕上檢視長文件時,請確認標題與清單仍然清晰可讀。使用 PDF 或 Markdown 格式,可確保檔案在不同行動裝置上顯示一致。
- 1在手機瀏覽器中開啟我們的文字翻譯器。
- 2貼上文字,或從雲端儲存上傳文件檔案。
- 3選擇目標語言並啟動翻譯程序。
- 4用雙指縮放檢視段落、項目符號清單與表格。
- 5下載並儲存高品質的譯文,即可開始分享。
決定你的長篇文字翻譯方式
把文件的大小與編輯需求,對應到最有效率的翻譯流程。
| 使用情境 | 最佳選擇 | 難點 |
|---|---|---|
| 翻譯文章或文案草稿,需要主動且即時的編修 | 互動式文字翻譯器 | 能逐段親手修飾,並立即調整術語。 |
| 翻譯長篇 DOCX 手冊或 Markdown 技術文件 | 具 AST 感知的文件翻譯器 | 自動保留複雜的格式結構、標題、清單與表格。 |
| 翻譯技術規格,術語必須嚴格統一 | 注入詞彙表的 AI 翻譯 | 自動套用你的自訂術語詞彙表,消除術語偏移。 |
| 出版備受矚目的企業報告或投資人簡報 | AI 版面草稿 + 雙關卡審校 | 人工複核有助於檢查術語、含義和版面,但不能保證完全無誤或符合法規。重要材料請由具備相關資格的專業人員審核。 |
獲得更好結果的技巧
依照語意標題分組內容
切分長文件時,請在清楚的標題或章節邊界切開,不要用任意的字數上限。這樣才能為翻譯模型保留完整的語言上下文。
建立雙語術語詞彙表
為專屬品牌名稱、產品術語與技術縮寫建立鎖定的詞彙表,確保所有頁面的用語絕對一致。
保護變數與預留位置
把系統變數(例如 `{userName}`)與 HTML 標籤鎖進翻譯指引,避免模型翻譯或破壞它們。
設定明確的語氣與風格指引
提供明確指示(例如「專業」或「口語」),讓翻譯模型在各章節維持一致的口吻。
分開檢查數字與否定語
特別掃描譯文文件中的價格、尺寸、日期與否定詞(不、從未),以抓出關鍵的準確性錯誤。
不看原文再讀一次譯文
最後單獨讀一遍譯文。這能幫你找出翻譯過程中被忽略的拗口語句或邏輯缺口。
處理前先清理來源文字
修正來源文件中的拼字錯誤、文法錯誤與冗長句。高品質的輸入是高品質譯文的前提。
維護結構化的翻譯記憶
把核准的譯文存進術語資料庫。重複使用已驗證的譯文字串,能節省時間並降低後續更新的處理成本。
常見問題
翻譯器如何在長檔中維持術語一致?
我們的引擎以滑動上下文視窗處理檔案,並允許你注入自訂術語詞彙表。翻譯器的參考資料庫會提示模型在各章節使用相同的詞,消除術語偏移。
可以翻譯含有數千個段落的書籍或手冊嗎?
可以,我們的文件翻譯器就是為處理大型檔案而設計的。它會把文件解析成結構化樹狀結構,並以平行串流處理,讓書籍與手冊翻譯快速又可靠。
如果翻譯模型改動了我的系統變數或程式碼預留位置怎麼辦?
為避免這種情況,請把程式碼區塊與變數鎖進你的翻譯指引。我們具 AST 感知的剖析器也會自動辨識並保護 Markdown 程式碼語法與動態欄位。
在手機上該怎麼處理翻譯?
開啟瀏覽器版的文字翻譯器,貼上文字或直接從「檔案」上傳文件,選擇目標語言,再用雙指縮放檢查技術細節後下載。
為什麼翻譯後文件的頁數變多了?
譯文所需空間會隨語言和措辭改變。請檢查實際輸出,並視需要調整字級、間距或頁邊距。
AI 文件翻譯用於機密商業檔案夠安全嗎?
是的,我們採用企業級安全協定。我們不會使用客戶資料或上傳的文件素材來訓練 AI 模型,確保你的敏感合約與內部報告維持保密。
以絕對一致的方式擴充你的翻譯流程
成功翻譯長篇文件,需要妥善管理語意邊界與術語詞彙表。逐段翻譯會剝掉上下文,並引發大量的一致性問題。
善用具 AST 感知的自動化文件翻譯器、匯入雙語詞彙表並預先考量語言擴張,你就能交付高影響力且專業的文件,在任何語言下都符合品牌標準。