PDF 進、PDF 出的工作流程
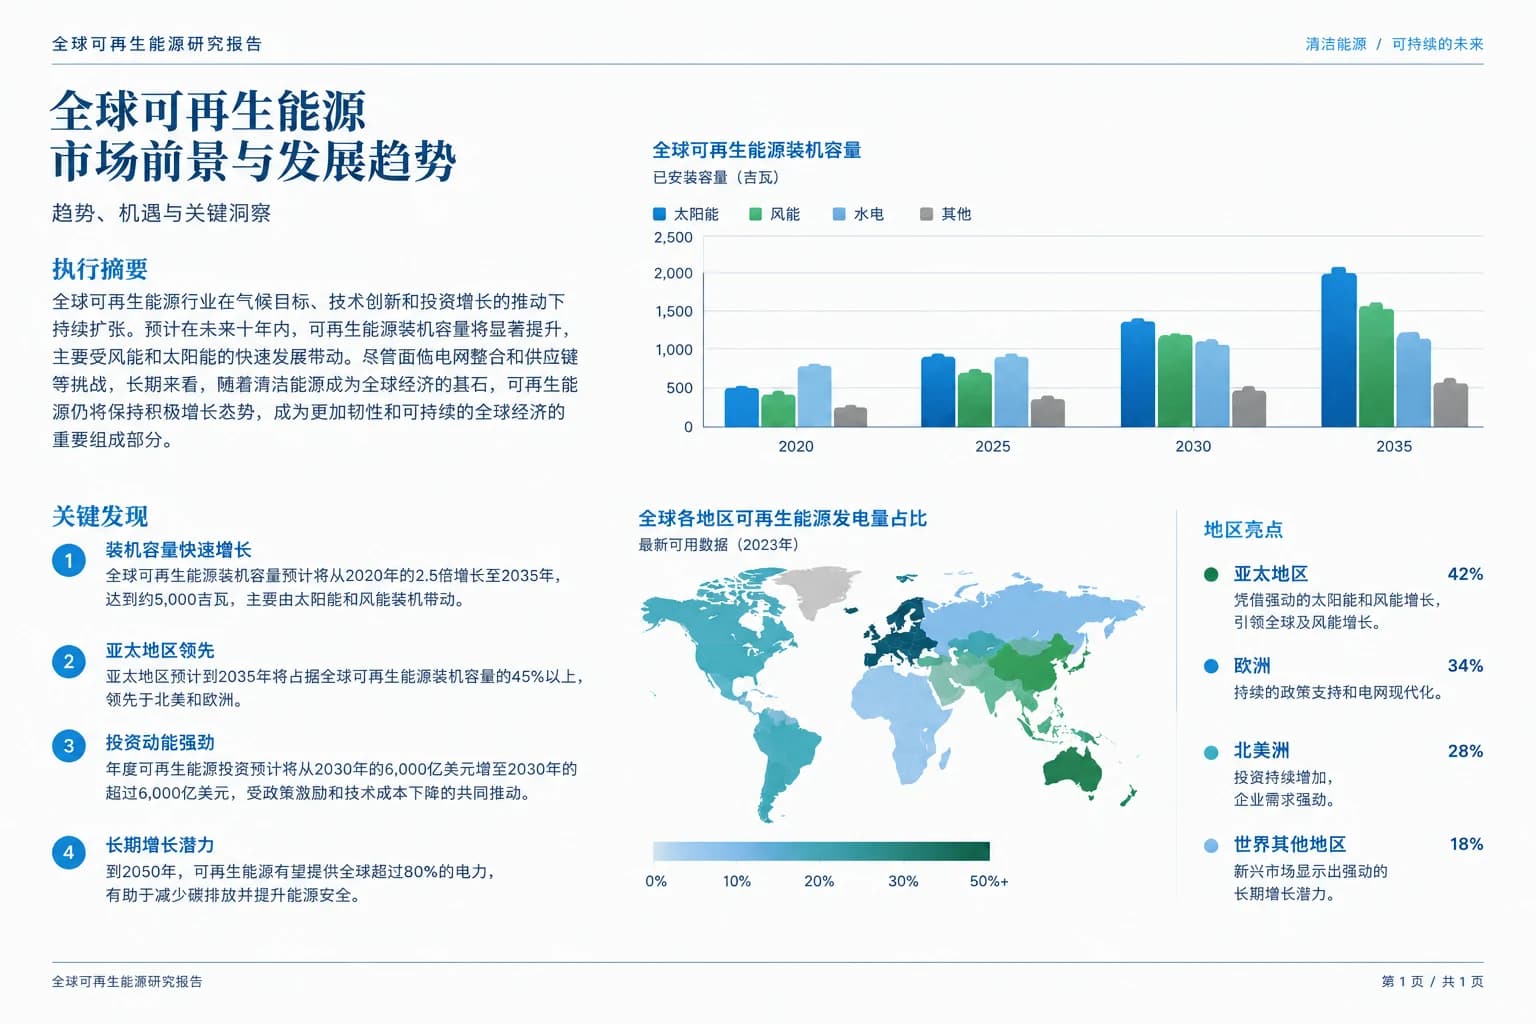
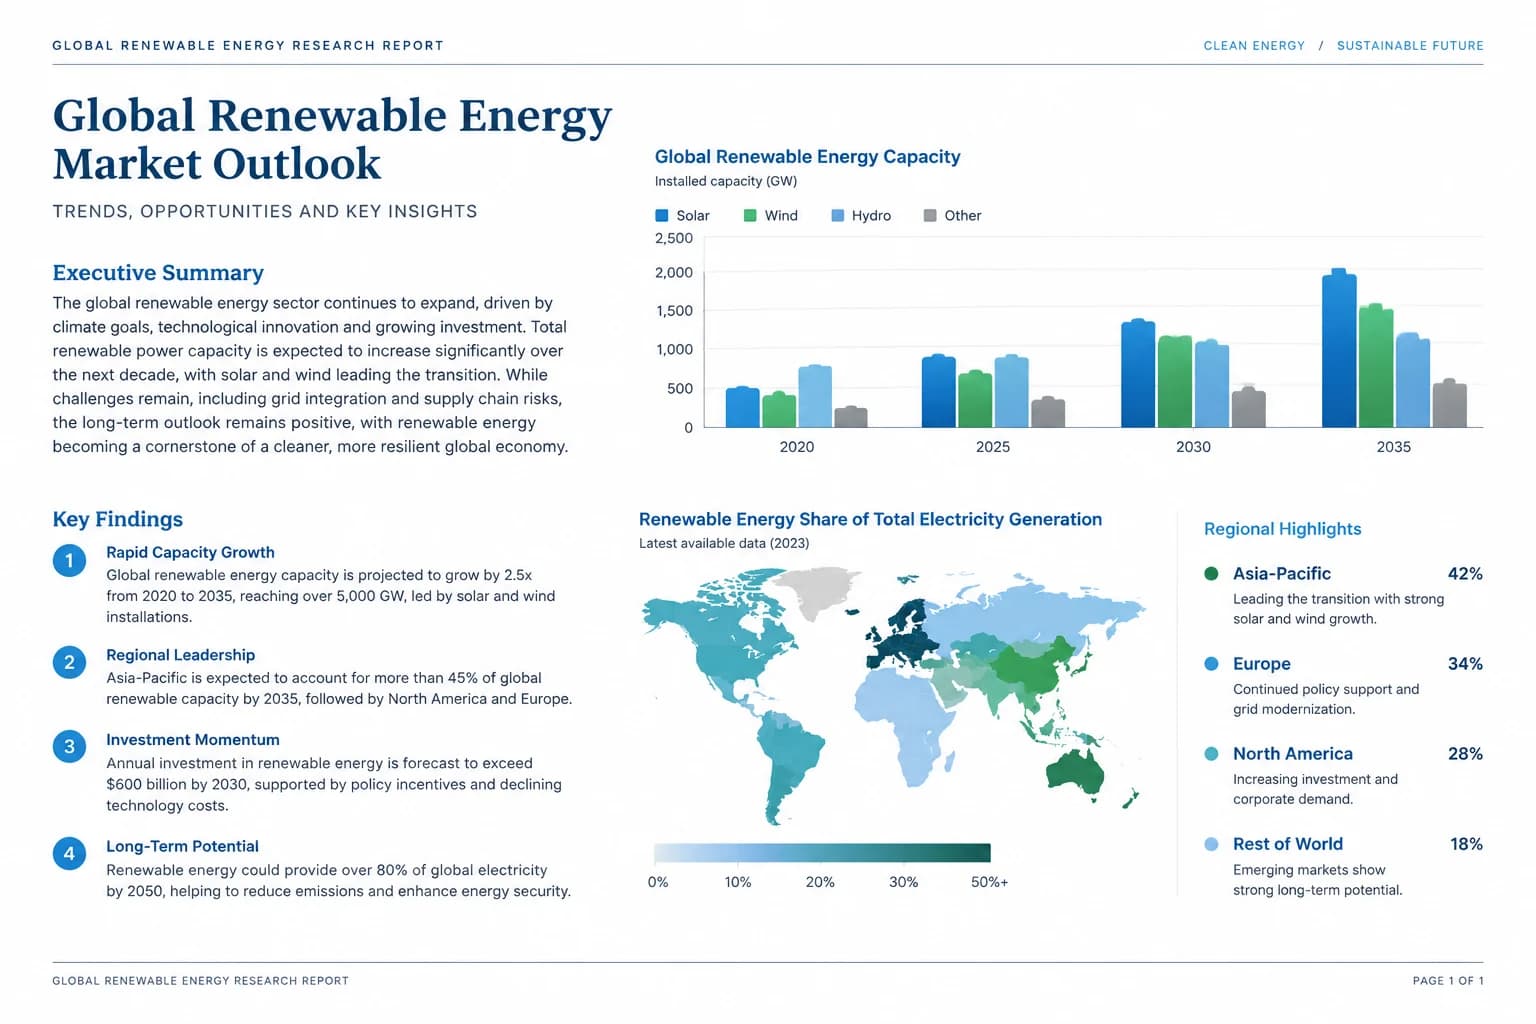
研究論文和報告
翻譯文章、白皮書和市場研究,同時保持圖表、標題和頁面順序。
上傳 PDF,並從同一個工作區下載翻譯後的輸出,而不是將每一頁複製到單獨的編輯器中。
示意範例;實際結果取決於原始檔案、語言和模型。
 ImageTranslate
翻譯原生或掃描的 PDF,盡可能保留頁面順序、版面配置、圖片和可選取文字。
請先選擇檔案——扣款前會顯示預估積分。
線上 PDF 翻譯器結合文字翻譯、可選 OCR 和可下載的檔案工作流程,適用於報告、手冊、論文和掃描文件。
翻譯文章、白皮書和市場研究,同時保持圖表、標題和頁面順序。
上傳 PDF,並從同一個工作區下載翻譯後的輸出,而不是將每一頁複製到單獨的編輯器中。
示意範例;實際結果取決於原始檔案、語言和模型。
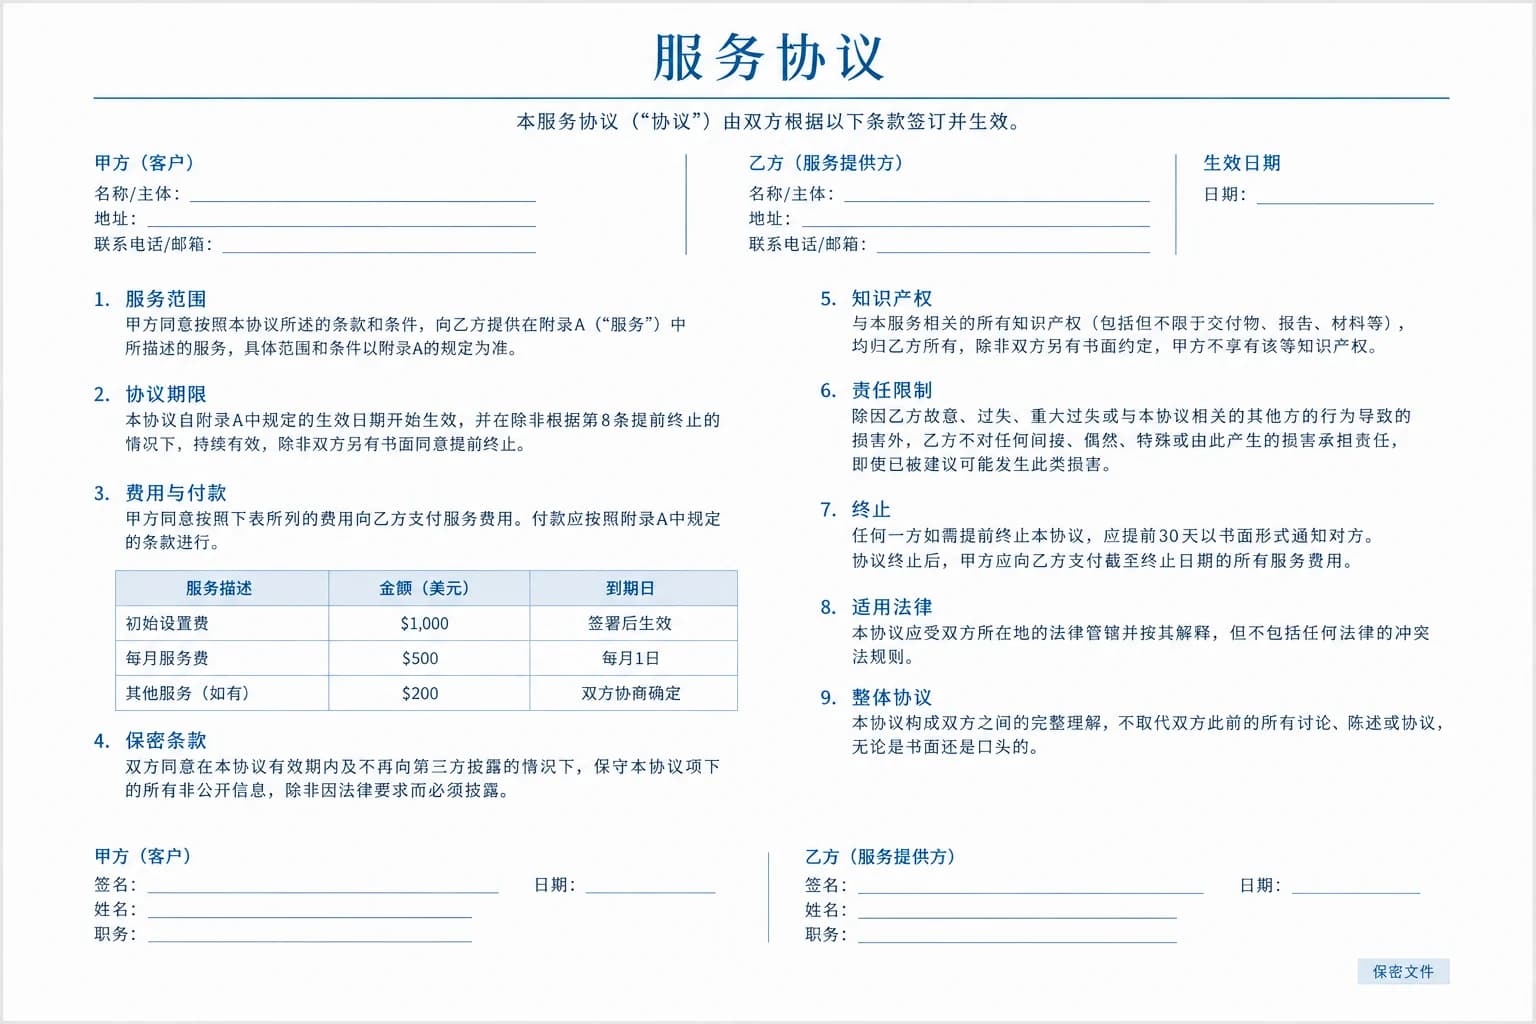
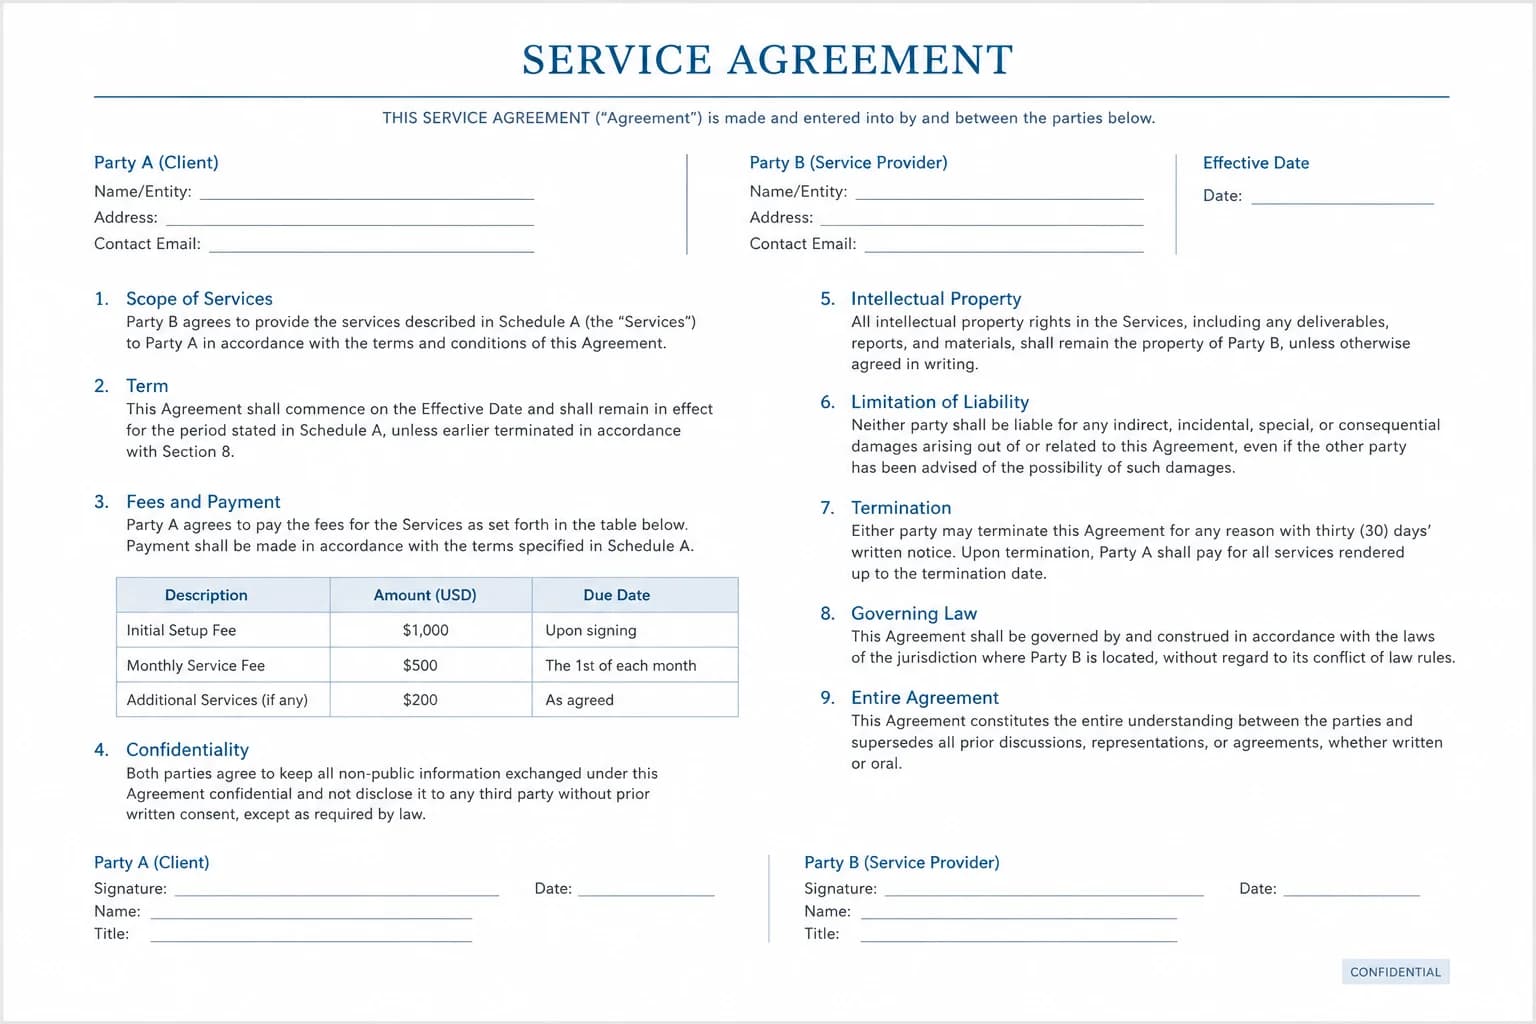
建立協議、提案、發票和政策文件的翻譯版本,供團隊審閱。
在來源格式允許的情況下,保持頁面順序、文字區塊、圖片和文件結構完整。
示意範例;實際結果取決於原始檔案、語言和模型。
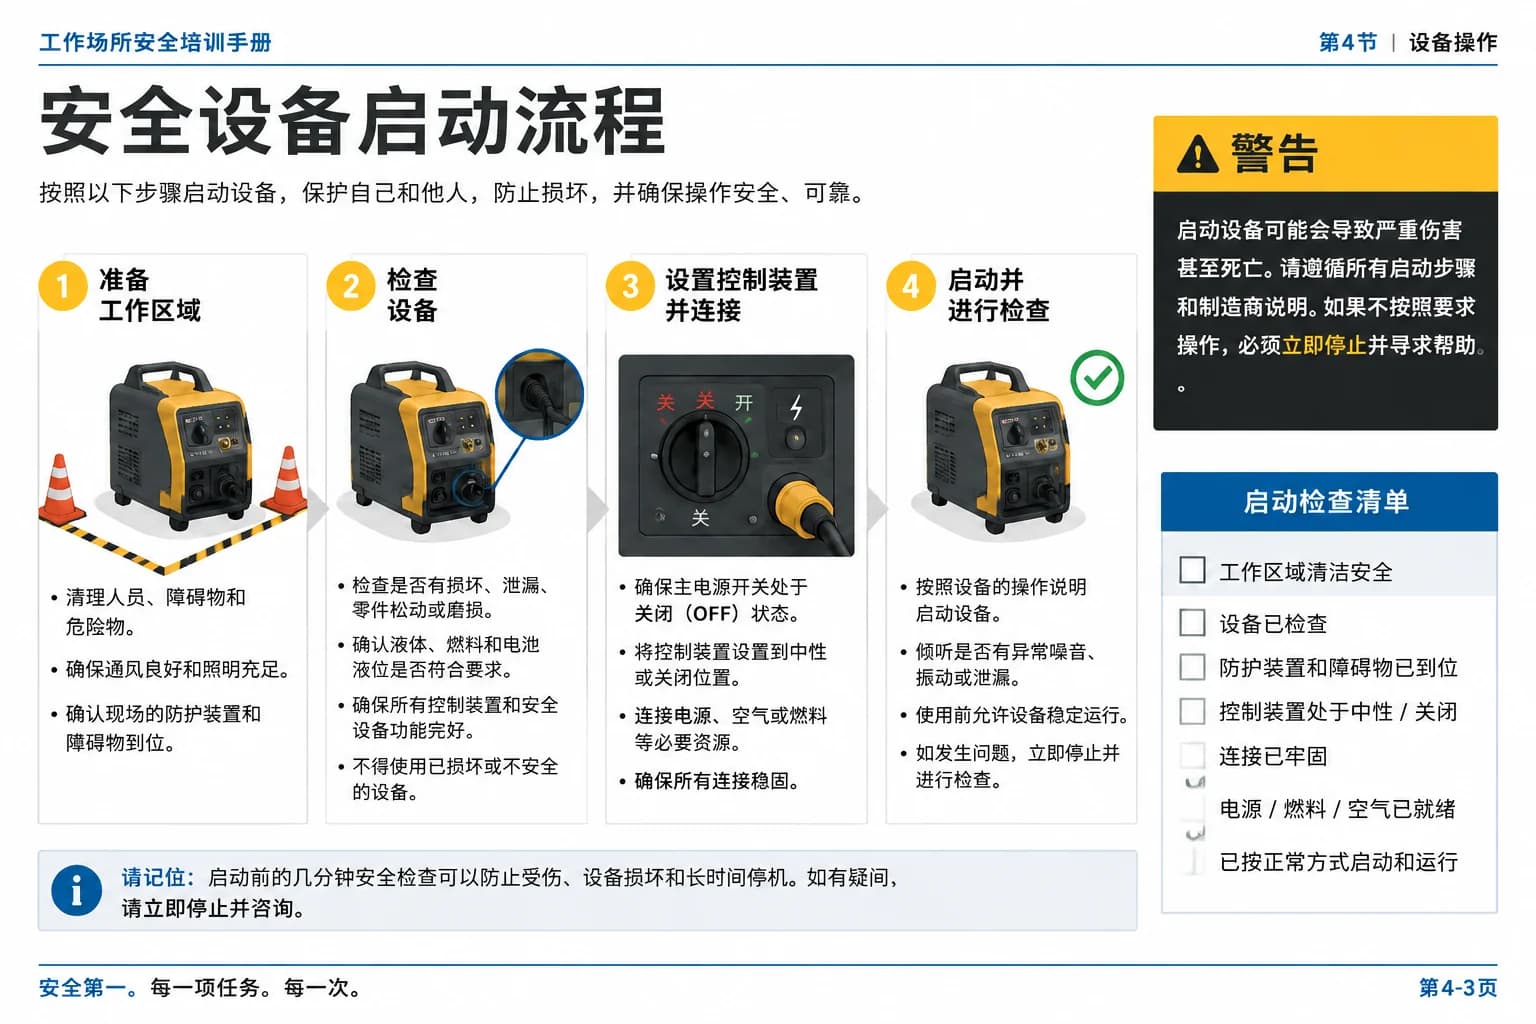
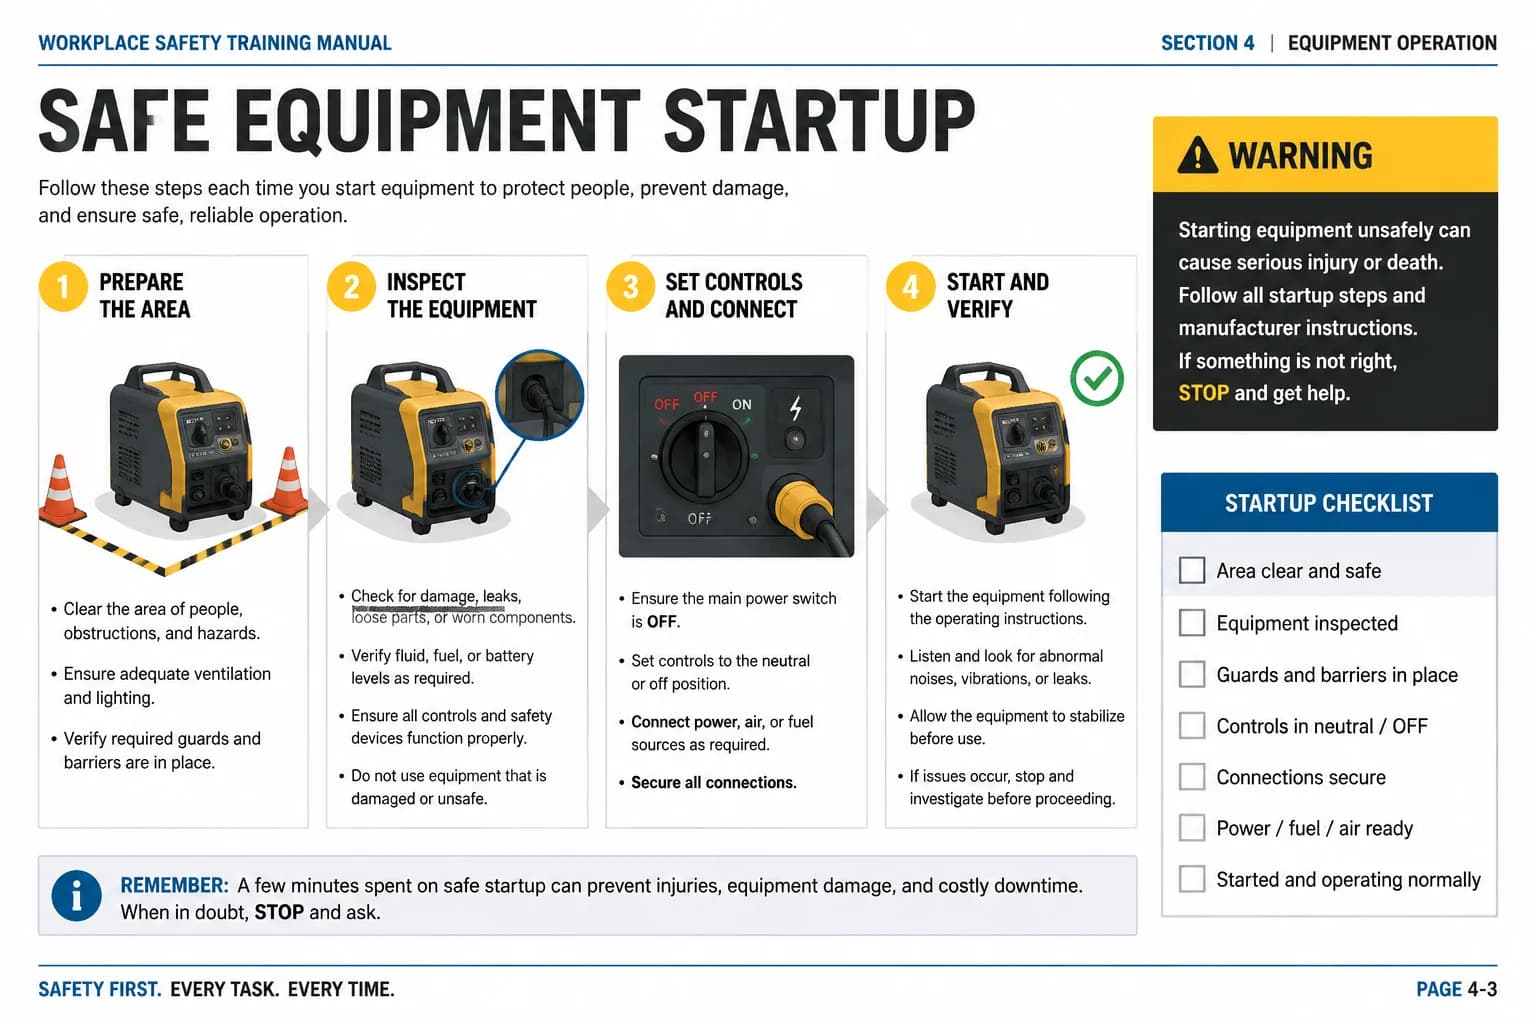
將產品手冊、入門指南和課程講義在地化,無需將來源分割成單一頁面。
輸入範圍如 1-3、7 來翻譯選定頁面,減少處理時間並控制點數使用。
示意範例;實際結果取決於原始檔案、語言和模型。
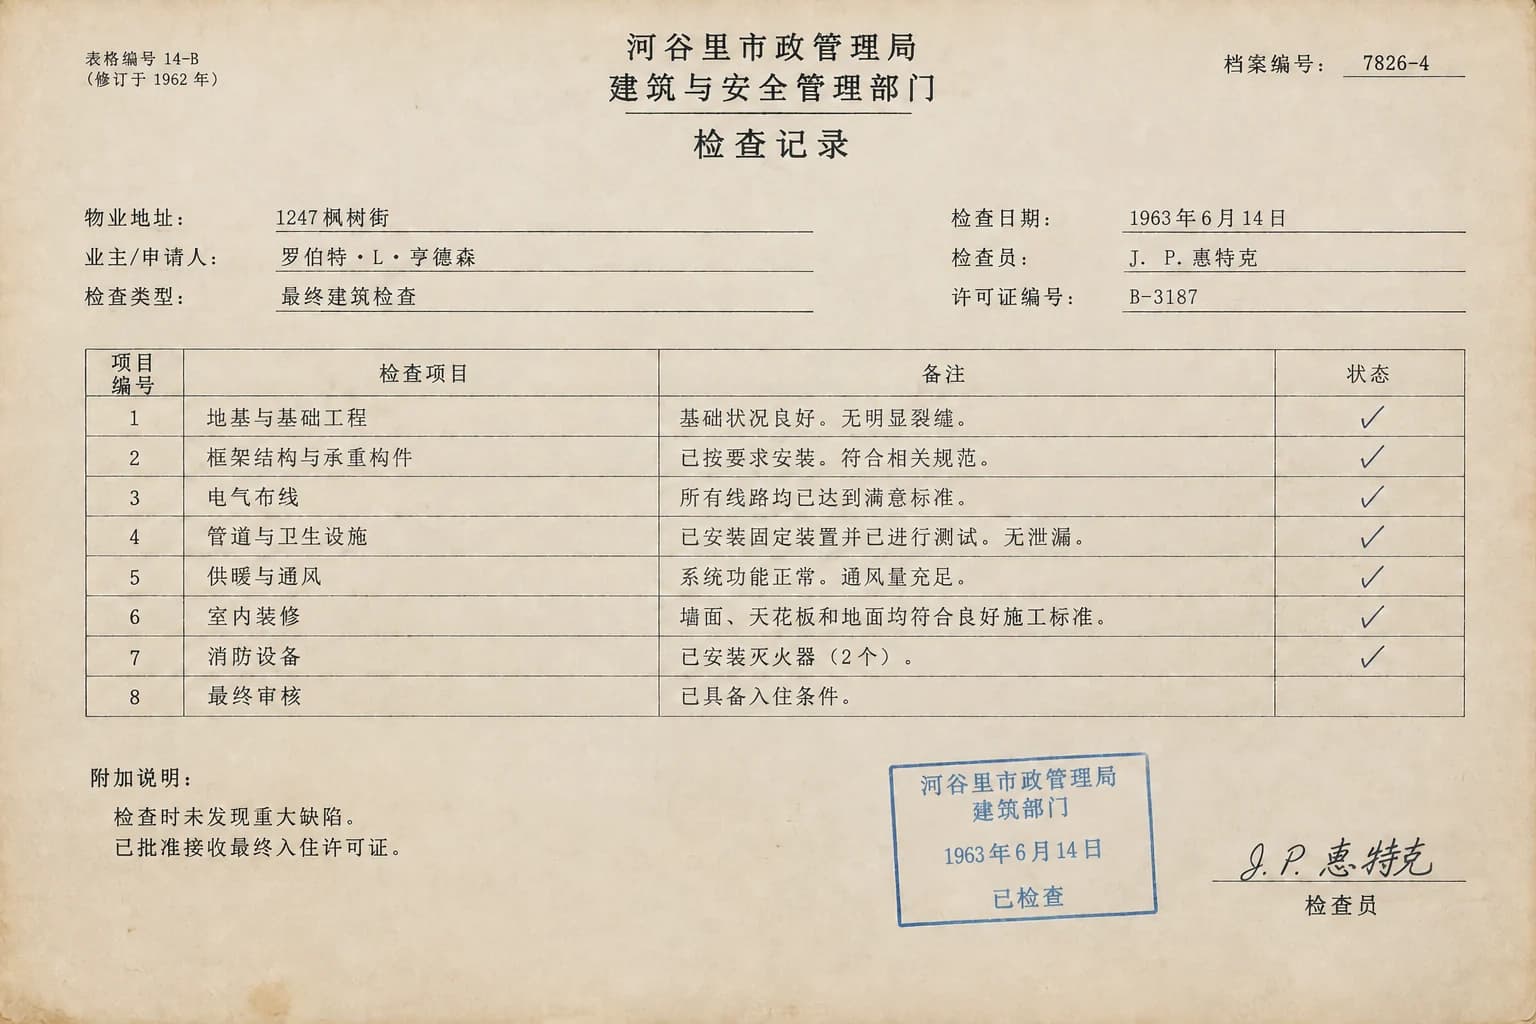
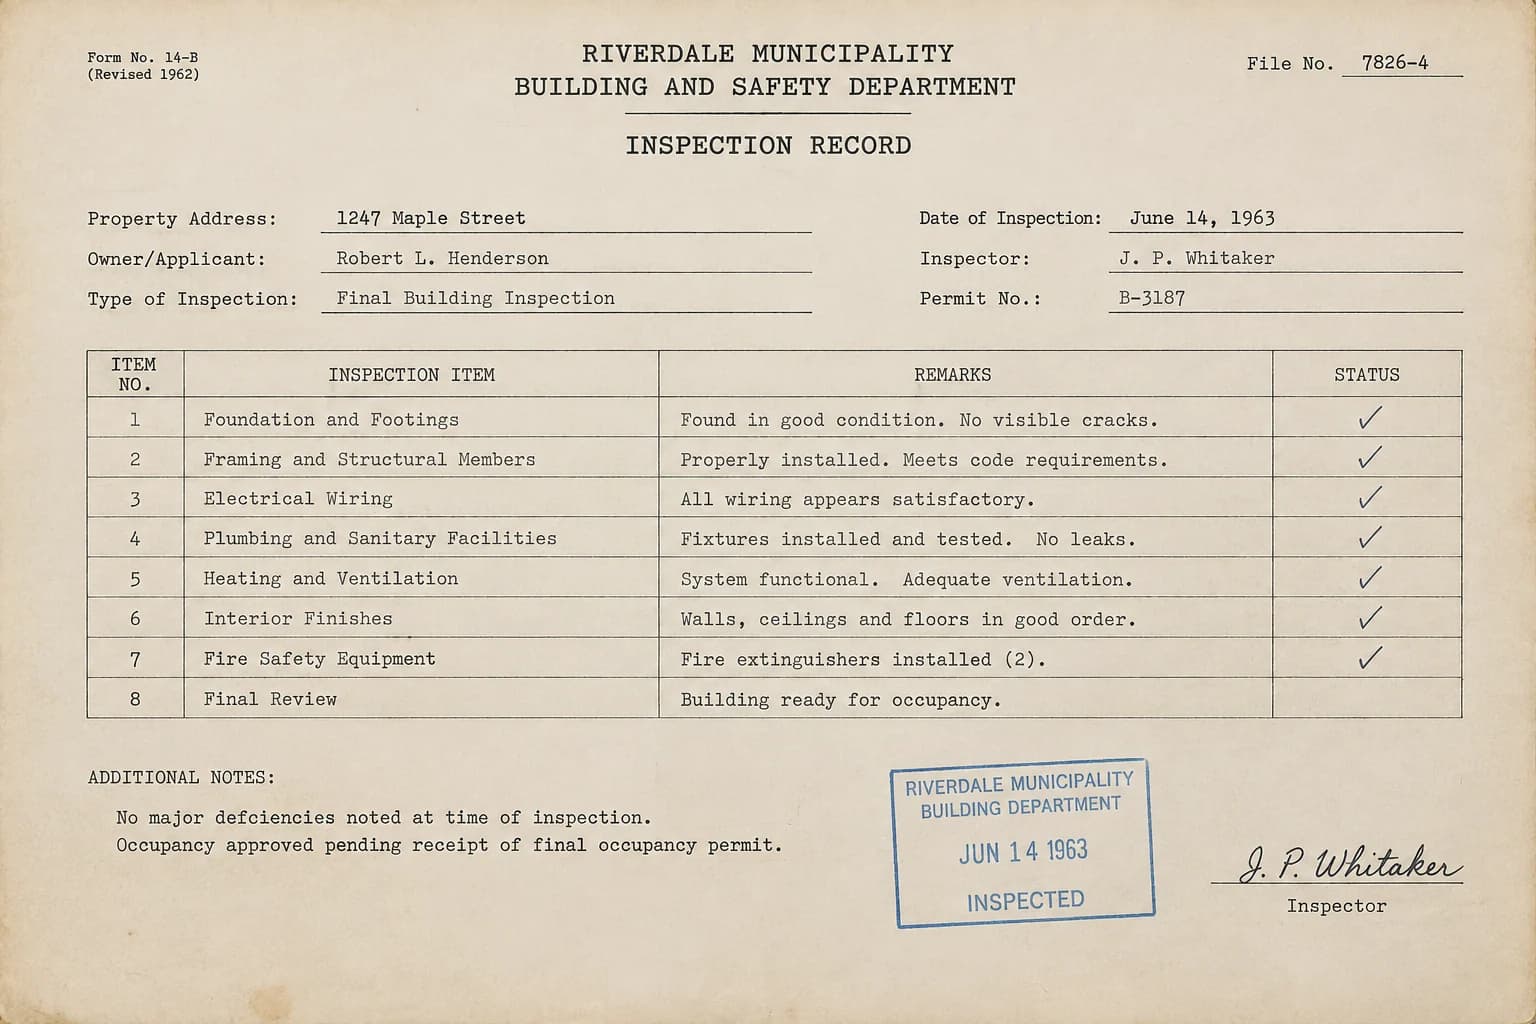
在翻譯沒有可選取 PDF 圖層的文字前,先對掃描報告、表單和記錄執行 OCR。
當檔案包含拍攝或掃描頁面且沒有可選取文字圖層時,啟用 OCR。
示意範例;實際結果取決於原始檔案、語言和模型。
從多種 AI 文字模型和 16 種支援語言中選擇,適用於商業、學術和技術資料。
排入佇列的翻譯會在背景持續處理,輸出完成後可從「我的空間」取得。
翻譯完整文件或選定範圍。工作區會在提交工作前顯示預估。
選擇原生或掃描 PDF。上傳器會檢查格式、檔案大小和預估頁數。
選擇目標語言、選擇 AI 模型、輸入選用頁面範圍,並為掃描頁面啟用 OCR。
檢視點數預估、提交工作,並在處理完成時下載翻譯後的 PDF。
可以。免費帳戶包含可用於試用 PDF 翻譯的點數。您可以處理的頁面數量取決於檔案、OCR 以及您方案中可用的點數。
ImageTranslate 旨在盡可能保留來源 PDF 的頁面順序、文字區塊、圖片和文件結構。非常複雜的版面可能仍需要最終的人工審閱。
可以。對僅含圖片或掃描的頁面開啟 OCR。OCR 會先辨識文字,然後所選的 AI 模型會將其翻譯成您的目標語言。
可以。輸入個別頁面或範圍,例如 1-3、7。翻譯較小的選取範圍可以減少處理時間和點數使用量。
PDF 翻譯器支援 16 種熱門語言,包括英文、中文、日文、韓文、西班牙文、法文、德文和葡萄牙文。您也可以使用自動來源語言偵測。
處理時間取決於頁面數量、檔案複雜度、OCR 和佇列負載。大型作業會在背景執行,因此您可以返回「我的空間」查看結果。
PDF 大小限制取決於您的方案。上傳器會顯示目前限制,而定價頁面會比較每個層級可用的限制。
將文字複製到一般翻譯器可能對段落有效,但當來源是多頁文件時,會變得緩慢且容易出錯。
| 比較 | ImageTranslate | 複製貼上翻譯 |
|---|---|---|
| 文件結構 | 頁面和檔案結構保留在單一工作流程中 | 文字與來源文件分離 |
| 掃描頁面 | 選用 OCR 讀取僅影像頁面 | 需要額外的 OCR 步驟 |
| 選定頁面 | 翻譯完整檔案或自訂頁面範圍 | 逐頁選取並重複 |
| 輸出 | 可下載的翻譯後 PDF | 鬆散翻譯文字 |
原生 PDF 包含真實文字圖層。您通常可以選取、搜尋和複製其文字,這為翻譯器提供乾淨的來源,並使處理更直接。匯出的報告、數位合約、電子書和 Office 文件通常是原生 PDF。
掃描 PDF 由頁面影像組成。即使字母在螢幕上看起來清晰,底下可能沒有機器可讀的文字。啟用 OCR 會告訴 ImageTranslate 在翻譯前辨識這些頁面影像上的文字。清晰、直立的掃描且對比度佳,會產生最佳結果。
對於大型檔案,先只翻譯需要的頁面。頁面範圍讓您更容易測試術語、檢視輸出品質,並在處理整個文件前控制點數。工作區顯示的預估是根據選定頁面和是否啟用 OCR。