如何翻譯文件而不遺失格式
直接解答 直接翻譯原生 DOCX、TXT 或 Markdown 檔案,以保留樣式、巢狀表格、清單與超連結。 上傳前務必接受所有追蹤修訂、解決註解並清理來源文件,避免 AI 上下文被汙染。
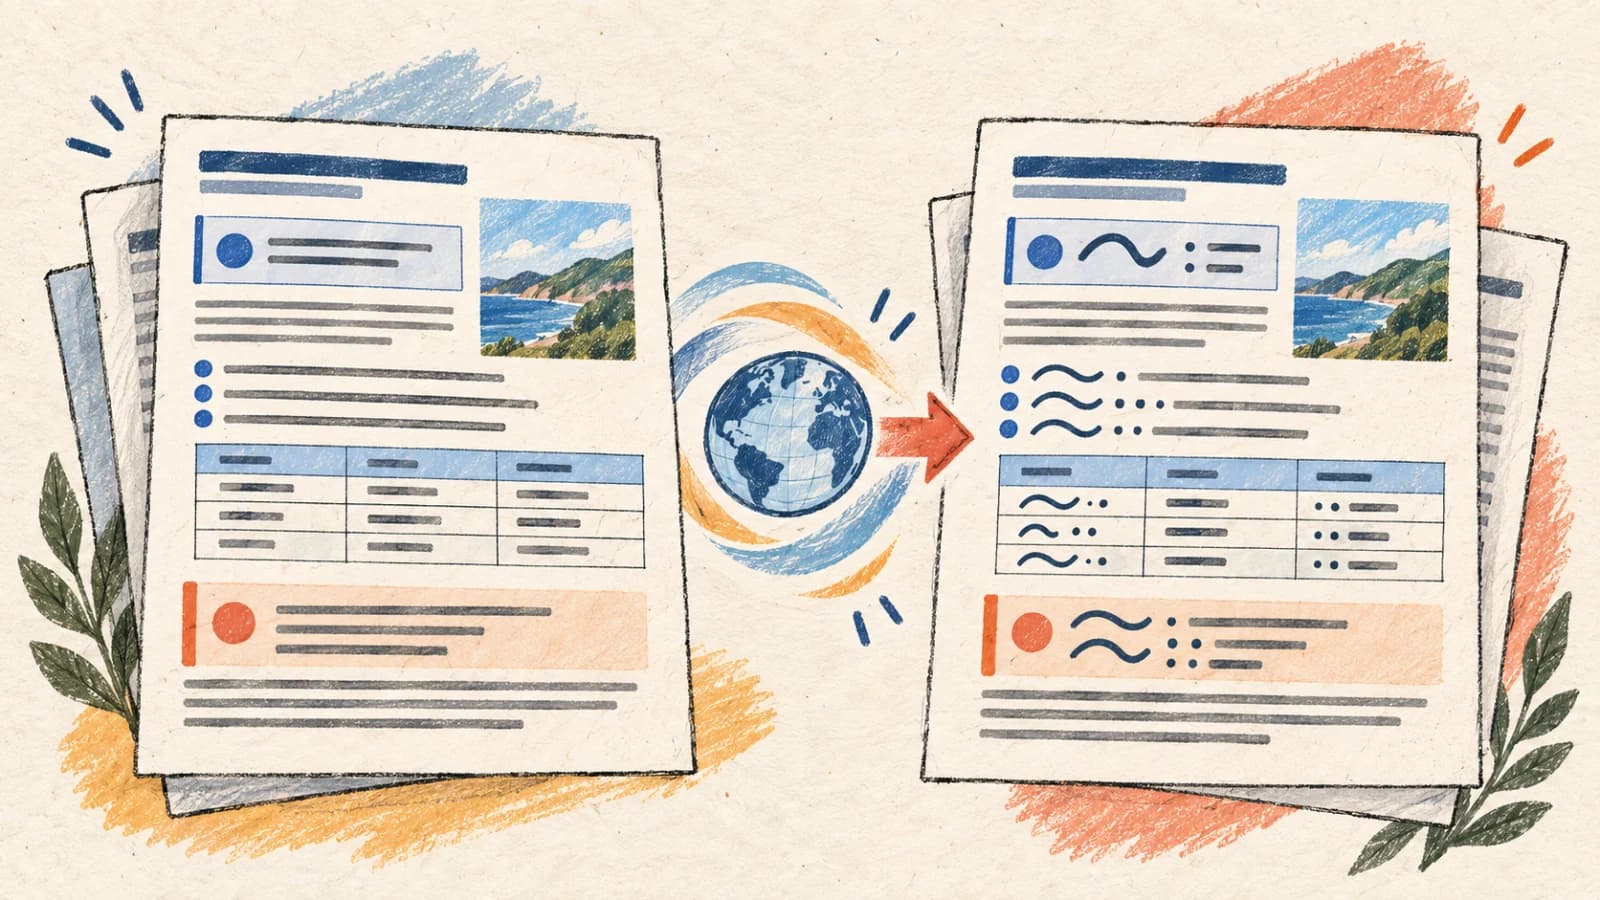
翻譯結構化文件時,絕對不該把段落手動複製進一個純文字框。這種做法雖然翻出了文字,卻會剝掉標題、表格、超連結、程式碼區塊、清單與頁面版面格式;翻譯完再手動重建這些格式結構,非常耗時。
當你要在地化報告、指南、提案、書稿或政策手冊時,請直接上傳原始文件格式。文件翻譯器會以 AST(抽象語法樹)與 OpenXML 結構剖析器解析檔案,在翻譯文字內容的同時保留所有格式標籤、表格結構與樣式。
本篇技術指南說明為什麼格式會在翻譯時跑掉、比較自動化與手動流程、列出行動裝置上的最佳化步驟,並提供翻譯前檢查與翻譯後查核清單。
重點整理
- 直接翻譯原生 DOCX、TXT 或 Markdown 檔案,以保留樣式、巢狀表格、清單與超連結。
- 上傳前務必接受所有追蹤修訂、解決註解並清理來源文件,避免 AI 上下文被汙染。
- Markdown 與純 TXT 檔案在以內容為主、視覺頁面格式與內容分離的流程中效率極高。
- PDF 翻譯應保留給必須完全鎖定版面的唯讀散布用途。
- 把品質檢查拆成語言翻譯與視覺版面兩道關卡,才能確保準確度。
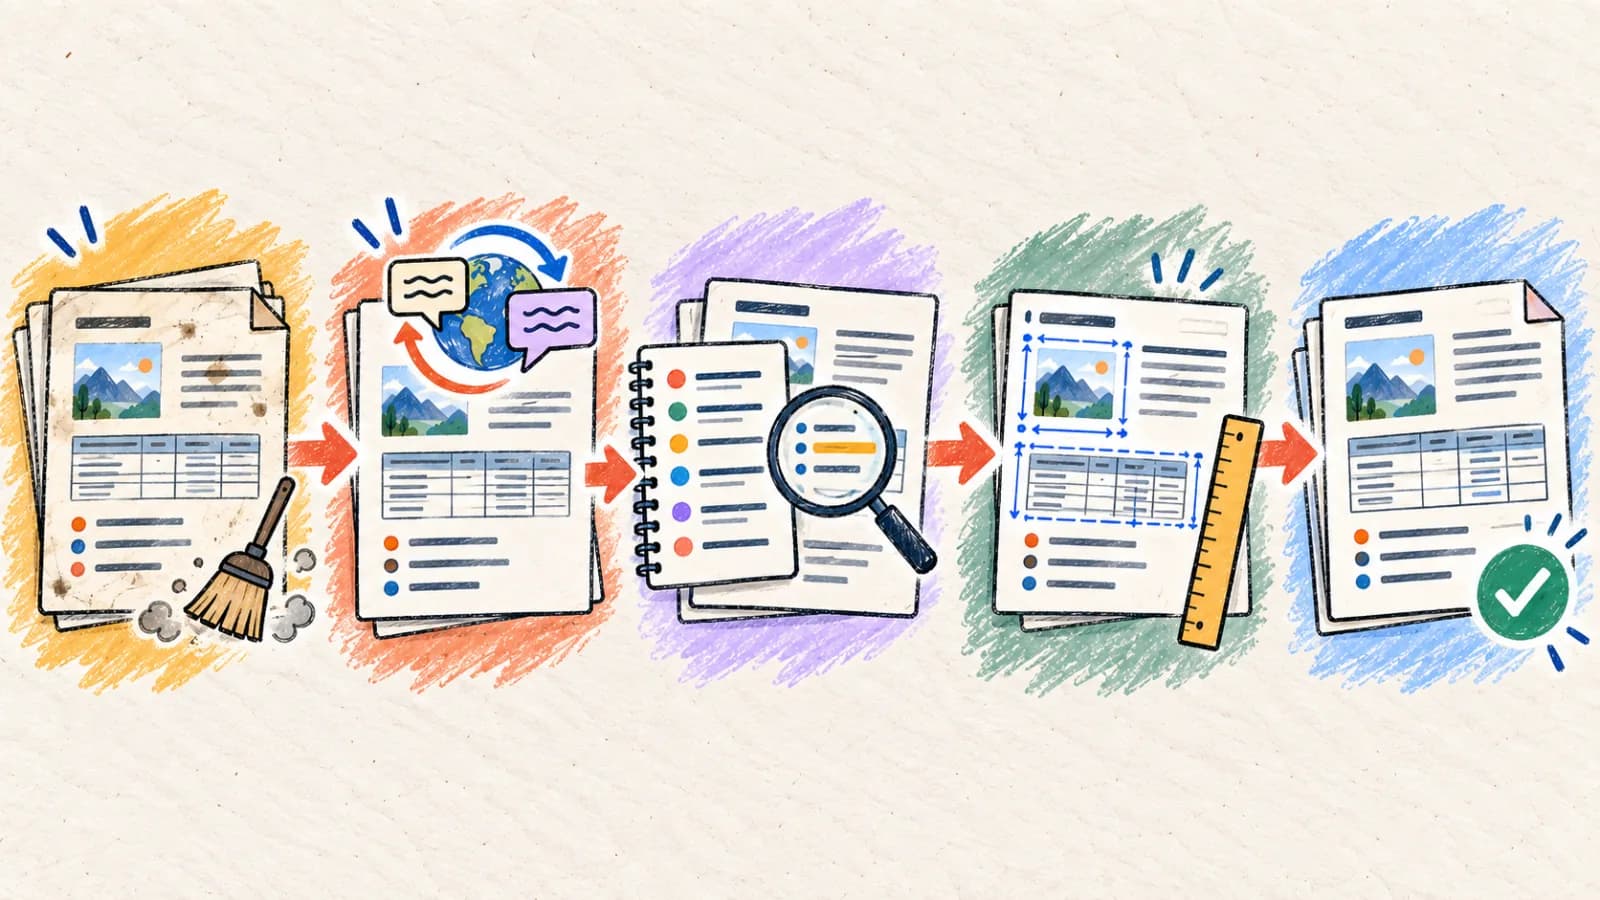
為什麼文件翻譯後格式會改變?
文件檔案是由文字片段、樣式、參照與表格儲存格組成的複雜樹狀結構。機器翻譯必須在不破壞格式標籤的情況下處理這份資料結構。
文字擴張改變頁面流向
譯文所需空間會隨語言和措辭改變。請檢查實際輸出,並視需要調整字級、間距或頁邊距。
XML 片段碎裂
由於拼字檢查、格式變更或追蹤修訂,DOCX 檔案中的單一單字可能被拆散在多個 XML 標籤裡。基本剖析器會在這些邊界切斷句子結構,導致 AI 翻譯破碎且不正確。
表格儲存格的嚴格邊界
表格儲存格有固定的水平邊界。當譯文擴張時,文字被迫緊密換行,造成儲存格過高、欄位標題破版,除非調整格式比例,否則表格會變得難以閱讀。
動態欄位與自動產生的清單
目錄、頁碼、動態索引參照與註腳都依賴系統欄位。程式化翻譯必須把這些結構元件獨立出來,只翻譯可見文字,同時保留底層的欄位結構。
追蹤修訂與註解造成的膨脹
含有未解決修訂、已刪除文字片段或編輯註解的文件,等於同一個句子同時存在多個重疊版本。直接翻譯這些內容,會產生冗贅且令人困惑的輸出。
翻譯文件的四種方法
請依據目標檔案格式、編輯需求與翻譯規模,選擇適合的文件翻譯方式。
方法 1:翻譯原生 DOCX、TXT 或 Markdown 檔案
報告、企業手冊、指南、書稿、合約與技術文件,且文字必須維持完整可編輯的情況。
具 AST 感知的文件翻譯器會剖析文件的檔案結構(例如 Word 的 OpenXML 或 Markdown 的 AST 樹),把文字獨立出來,用具上下文感知的模型翻譯,再原地寫回字串。這能保留所有標題、表格結構、項目符號清單與超連結節點。
這是最有效率的方法,因為輸出檔案仍完整可編輯且保有樣式。為確保最佳品質,請在上傳翻譯前先清理來源檔案,解決所有追蹤修訂與編輯註解。
操作步驟
- 開啟來源文件,接受所有追蹤修訂、解決註解,並刪除未使用的格式圖層。
- 把清理乾淨的 DOCX 或 Markdown 檔案直接上傳到文件翻譯器。
- 選擇目標語言,並設定標準的翻譯指引與術語詞彙表。
- 執行翻譯,下載保留樣式且完整可編輯的在地化文件。
- 檢視輸出版面,調整表格欄寬與分頁位置以容納擴張的文字。
- 確認所有超連結仍然有效,並指向正確的在地化 URL。
- 若是 Markdown 檔案,請確認 frontmatter 中繼資料區塊與程式碼區塊格式沒有被破壞。
方法 2:轉成 PDF 再翻譯 PDF 版面
靜態企業報告、型錄、發票與參考手冊,頁面版面必須完全鎖定的情況。
如果你的最終文件是唯讀 PDF 講義,維持精準頁面版面比可編輯性更重要,那就可以跳過文件編修。先把檔案轉成 PDF,再交給保留版面的 PDF 翻譯器處理。
這個方法會把所有文字區塊、表格與圖片固定在原位,避免任何頁面流向位移或表格對齊問題。但最終產出是靜態 PDF,日後若要編輯文字圖層,就需要專業的 PDF 工具。
操作步驟
- 把套好樣式的文件另存為標準 PDF 檔案。
- 將 PDF 上傳到我們的 PDF 翻譯器,並選擇目標語言。
- 檢視譯文版面,確認表格、頁首與頁尾對齊正確。
- 確認字型顯示正確,且沒有文字片段被裁切。
- 下載並散布最終鎖定版面的譯文 PDF。
方法 3:擷取文字區塊,互動式翻譯後再重建
短篇技術文案、廣告活動與單頁表單,需要精準且互動式調整術語的情況。
對於用字極為關鍵的短文件(例如廣告活動或表單),翻譯整個檔案反而會多出不必要的格式步驟。這時可以手動擷取文字區塊,或交給文字翻譯工具處理。
這種做法讓你能在螢幕上互動式翻譯段落、測試不同術語選擇並修飾譯文。定稿後,再把核准的文案貼回你套好樣式的文件範本。
操作步驟
- 把文件中的文字區塊擷取到互動式文字翻譯器中。
- 選擇目標語言並設定術語詞彙表,確保品牌一致性。
- 互動式翻譯各段落,調整句子使語意清晰、語氣流暢。
- 把核准的在地化文字貼回你的主文件範本。
- 確認文件格式無誤後再散布定稿檔案。
方法 4:使用專業的 XLIFF / CAT 翻譯流程
企業級文件在地化專案,會使用翻譯記憶資料庫伺服器與認證譯者審校的情況。
在大型企業文件翻譯中,檔案是交由專業的電腦輔助翻譯(CAT)工具處理的。文件的結構節點會被擷取成標準 XLIFF 檔案,把字串獨立出來的同時保護格式標籤。
專業譯者搭配術語詞彙表與翻譯記憶資料庫翻譯這些 XLIFF 對照表。翻譯完成後,核准的字串會重新匯入文件結構。這能確保企業級的語言品質,但之後仍需要人工查核版面。
操作步驟
- 把來源文件轉換成結構化的 XLIFF 或 Excel 檔案。
- 將檔案送交認證譯者,或透過企業翻譯平台處理。
- 把譯文字串匯回原生文件格式。
- 手動檢視版面,修正任何頁面溢出或欄位對齊問題。
- 匯出定稿文件,並將翻譯記憶歸檔供日後更新使用。
如何在行動裝置上翻譯文件
在行動裝置上翻譯文件,對商務出差來說非常方便。請改用可在雲端直接處理檔案的回應式瀏覽器翻譯工具,不必安裝笨重的桌面軟體。
在手機螢幕上檢視譯文文件時,請確認清單、表格與標題仍然清晰可讀。使用 PDF 或 Markdown 格式,可確保檔案在不同行動裝置上顯示一致。
- 在手機瀏覽器中開啟我們的文件翻譯器。
- 從「檔案」或雲端儲存上傳你的文件(DOCX、TXT 或 Markdown)。
- 選擇目標語言並啟動翻譯程序。
- 放大檢視標題、項目符號清單、表格與超連結。
- 下載並儲存高品質的譯文文件,即可開始分享。
決定你的文件翻譯方式
把文件的編輯需求與視覺版面複雜度,對應到最有效率的翻譯流程。
| 使用情境 | 最佳選擇 | 難點 |
|---|---|---|
| 翻譯手冊、指南或報告,且必須維持完整可編輯性 | 自動化文件翻譯器(DOCX/Markdown) | 擷取並翻譯文字區塊,同時完整保留標題、清單、表格與格式。 |
| 分享靜態講義或企業政策文件 | 轉成 PDF + PDF 翻譯器 | 鎖住所有頁面元素,避免容器溢出與字距位移。 |
| 處理短篇技術文案或廣告活動,用字必須精準 | 互動式文字翻譯器 | 可即時互動翻譯並編修關鍵術語。 |
| 管理大型企業文件在地化專案 | XLIFF/Excel CAT 翻譯流程 | 能與標準翻譯記憶及專業譯者審校流程順暢整合。 |
獲得更好結果的技巧
清理來源文件的修訂記錄
翻譯前務必接受所有追蹤修訂、解決編輯註解並移除未使用的格式樣式。未解決的修訂會讓文件結構碎裂,破壞翻譯品質。
保護 Markdown 格式標籤
翻譯 Markdown 時,請確保程式碼區塊、粗體標記與 frontmatter 中繼資料鍵受到保護。AI 模型不應該翻譯或改動語法結構。
為文字擴張預留邊界
譯文所需空間會隨語言和措辭改變。請檢查實際輸出,並視需要調整字級、間距或頁邊距。
統一採用 Unicode 字型
選擇跨平台、符合 Unicode 的字型(例如 Arial 或 Noto Sans),支援非拉丁文字,避免在地化文件出現字型顯示錯誤。
檢查表格欄位換行
文字擴張常迫使譯詞在狹窄的表格邊界內換行。請放寬欄寬限制或調整字級,讓表格維持可讀。
鎖定技術詞彙與品牌術語
確保型號、SKU 代碼與專屬品牌名詞受到保護。不可翻譯的資料在所有在地化文件版本中都必須保持一致。
檢查動態欄位與索引
翻譯 DOCX 檔案後,請在 Word 中更新目錄、頁碼等自動欄位,確認它們能正確對應在地化文字。
檢視目錄的頁碼對應
由於文字擴張會移動頁面邊界,匯出定稿文件前請務必更新目錄的頁碼對應。
常見問題
翻譯 Word 檔案會破壞項目符號清單與表格嗎?
不會。我們的自動化文件翻譯器直接剖析文件檔案結構,只擷取並翻譯文字節點。所有表格、清單結構、框線與樣式都會完整保留。
可以翻譯含有程式碼區塊與 frontmatter 的 Markdown 檔案嗎?
可以,我們的剖析器具 AST 感知能力。它能辨識 Markdown 格式語法、程式碼區塊結構與 YAML frontmatter 鍵,在只翻譯本文的同時保護這些內容。
如果譯文超出表格儲存格會怎麼辦?
文件翻譯器會解析儲存格邊界並優雅地換行。為避免出現過高而難以閱讀的表格列,你可以在編輯器中手動調整欄寬或縮小字級。
如何翻譯含有未解決追蹤修訂的文件?
強烈建議在上傳前先接受所有追蹤修訂並解決註解。含有進行中修訂的文件會有重疊的文字片段,破壞 AI 翻譯的上下文。
為什麼翻譯後標題換成了多行?
這是文字擴張的常見結果(例如英文譯成德文或西班牙文)。你可以手動調整文件邊界、縮小標題字級,或改用更精簡的措辭。
文件上傳有檔案大小限制嗎?
上傳限制取決於你目前的訂閱方案。如果檔案含有大型內嵌圖片或媒體素材,建議先移除再翻譯,之後再放回在地化的輸出檔案中。
保留文件結構,換來專業成果
成功翻譯文件,需要深入理解檔案結構與版面格式。標準的複製貼上做法會剝掉樣式,並引發大量的格式問題。
善用具 AST 感知的自動化文件翻譯器、在處理前清理來源檔案並預先考量語言擴張,你就能交付高影響力且專業的文件,在任何語言下都符合你的版面標準。