執筆 ImageTranslate · 編集方針
スキャンしたPDFを書式を保ったまま翻訳する方法
短い回答
PDF内で特定の単語を選択したり検索したりできない場合、そのドキュメントにはOCR対応の翻訳パイプラインが必要です。 段組みのPDFレイアウト(報告書や研究論文など)では、文の翻訳が混乱しないよう賢いブロックグループ化エンジンが必要です。
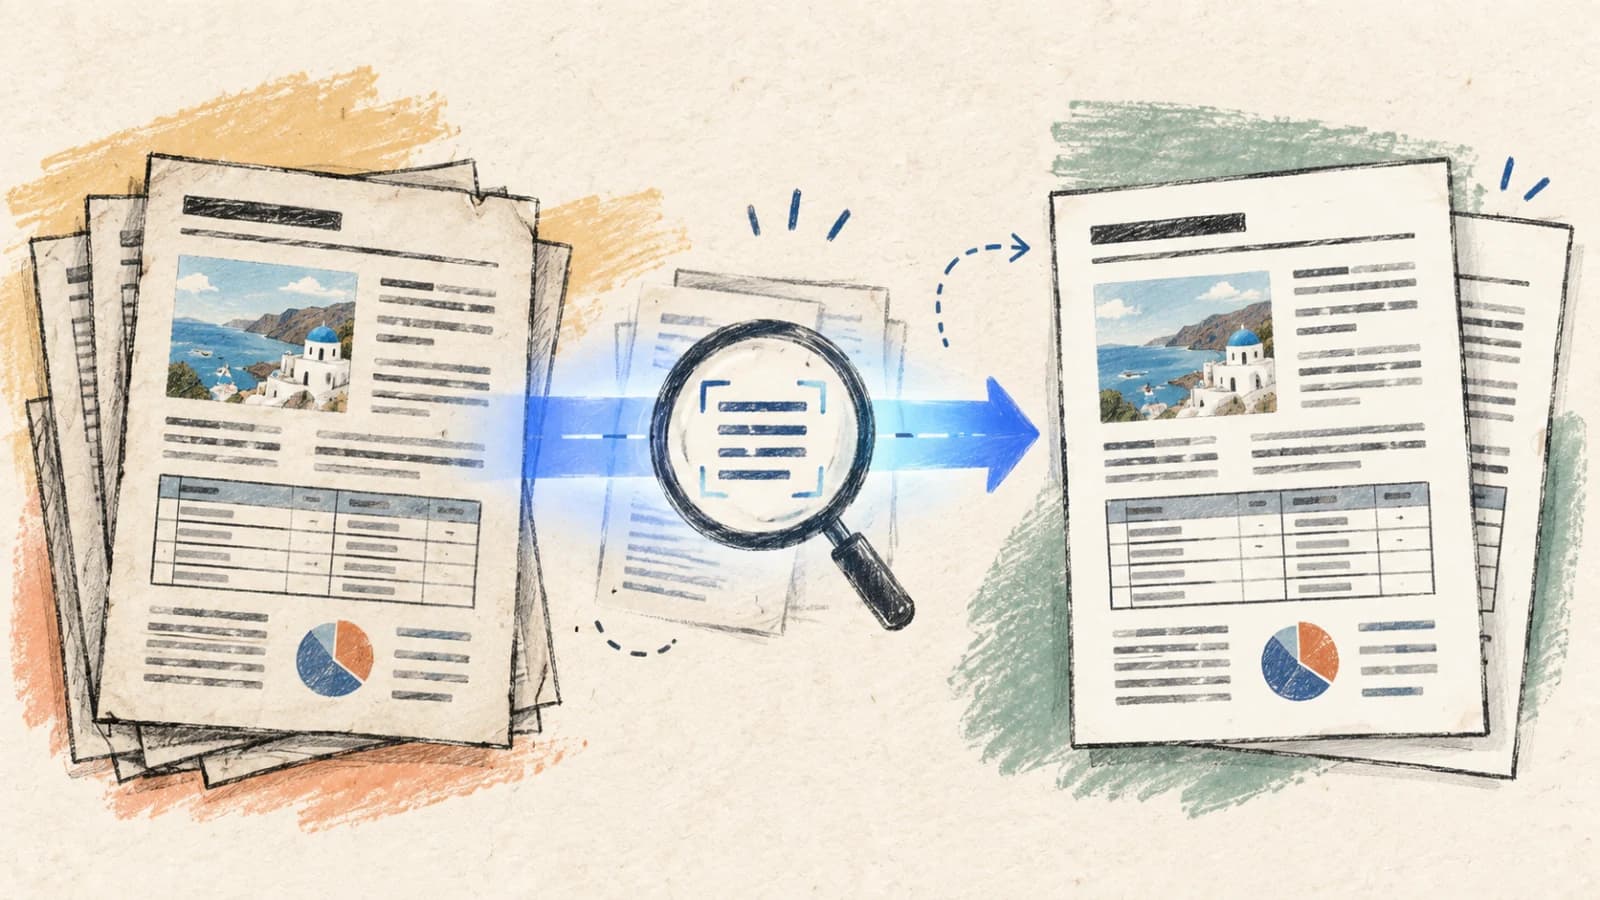
スキャンされたPDFは、本質的には高解像度のデジタル写真を1つのファイルに束ねたものです。背後にテキストレイヤーが存在しないため、通常のテキストコピーは失敗し、ドキュメント内検索はゼロ件を返し、基本的な翻訳ツールは白紙のページを出力するか書式エラーを起こします。
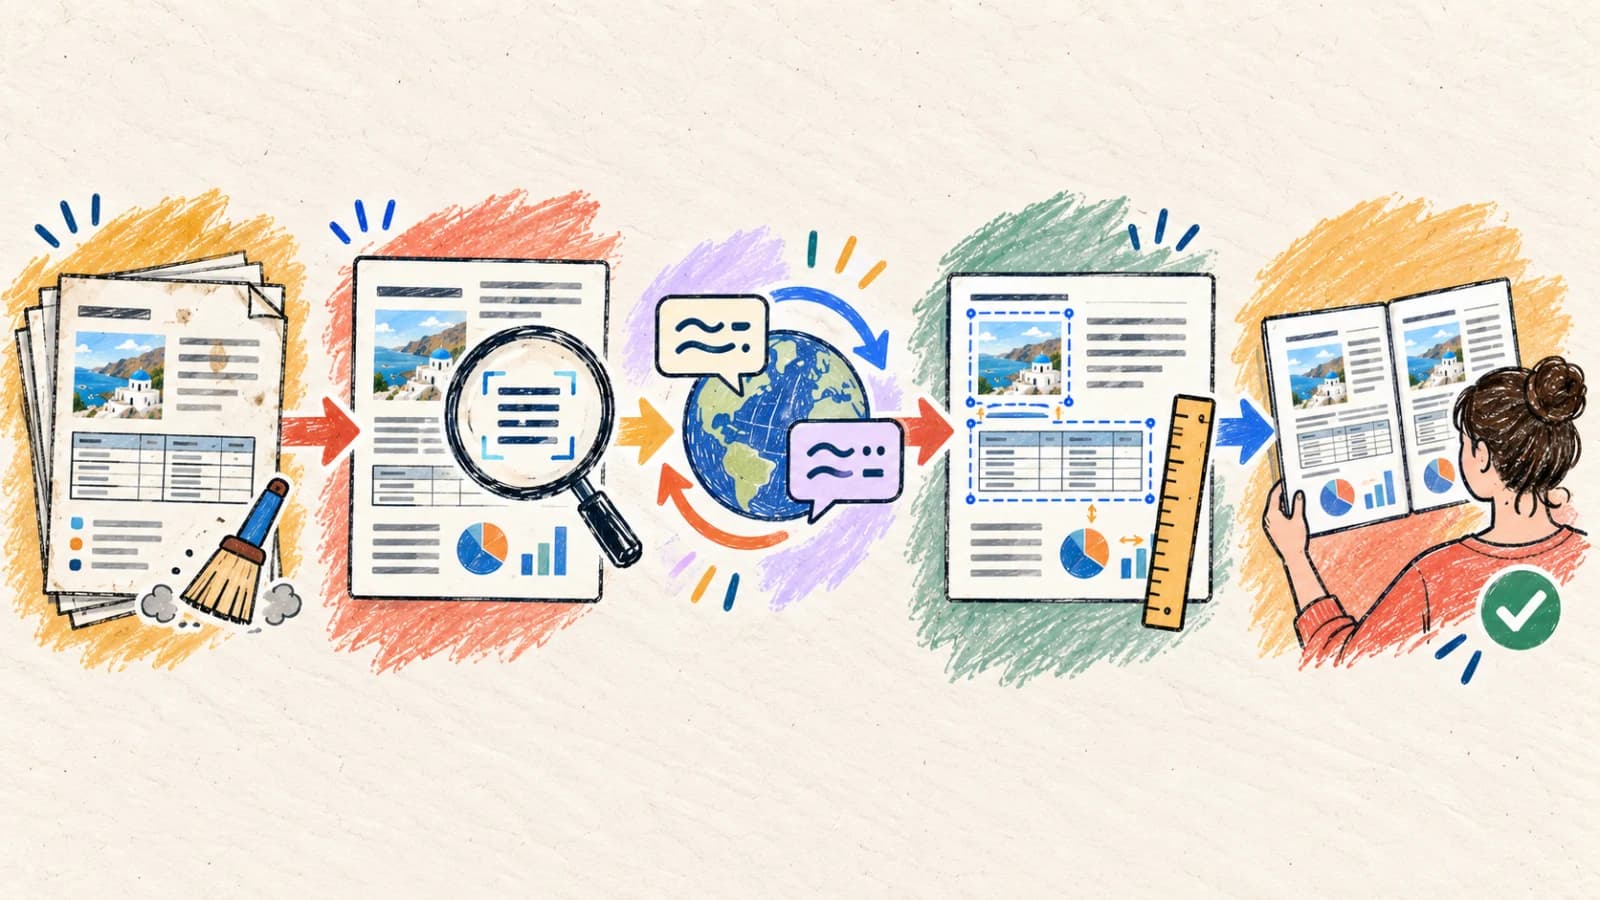
レイアウトを壊さずにスキャンPDFを翻訳するには、OCR(光学式文字認識)に対応したPDF翻訳ツールを使う必要があります。翻訳パイプラインは、空間的な座標データを抽出し、読み取りの流れ(段組みなど)を判定し、文脈を踏まえて文字列を翻訳し、新しいPDFファイルを動的に再構築します。この処理では、表示エラーを防ぐために適切なUnicodeフォールバックフォントの埋め込みも必要です。
この総合的なガイドでは、スキャンページの見分け方、複雑なドキュメントレイアウトの扱い、非ラテン文字の制約への対応、そして納品前の最終的なドキュメント構造の検証方法を詳しく解説します。
要点
- PDF内で特定の単語を選択したり検索したりできない場合、そのドキュメントにはOCR対応の翻訳パイプラインが必要です。
- 段組みのPDFレイアウト(報告書や研究論文など)では、文の翻訳が混乱しないよう賢いブロックグループ化エンジンが必要です。
- フォントフォールバックの組み込みが重要です。アラビア語、タイ語、中国語、日本語、韓国語への翻訳では、文字化けブロックを避けるために互換フォント(Noto Sansなど)の埋め込みが必要になります。
- ページ数の非常に多いドキュメントを処理するときは、翻訳するページ範囲を絞って処理コストとレビュー時間を抑えましょう。
- 表構造、脚注、小さなスタンプは、テキストの膨張時に書式が崩れやすいため特に注意してください。
なぜスキャンされたPDFは翻訳が難しいのか
ネイティブなドキュメントとは異なり、スキャンされたPDFにはレイアウトのベクターデータも文字情報もありません。別言語で同一の複数ページドキュメントを再構築するには、高度なドキュメント解析が必要です。
構造化されたテキストレイヤーの欠如
スキャナーはページを平面の画像として記録します。翻訳ツールは文字の視覚的な形状を解析し、それらをまとまりのある単語や段落に組み立て、テキストブロックを翻訳する前にレイアウト解析を行う必要があります。
段組みの読み取り順序の混乱
学術論文、雑誌、財務報告書は段組み、サイドバー、囲み記事を使います。単純なOCRエンジンはページ全体を水平方向に解析するため、独立した段を結合してしまい、言語的な文脈が壊れます。
非ラテン文字のフォントマップ情報の欠落
英語からアラビア語、タイ語、日本語などの非ラテン文字を使う言語に翻訳する場合、出力PDFには新しいフォントマップファイルを埋め込む必要があります。適切なフォールバックフォントがないと、PDFリーダーはグリフを表示できず、空の四角になってしまいます。
表内での厳格な境界の制約
表、フォーム、技術仕様書には物理的な境界があります。翻訳された文が元のセルの幅を超える場合、レイアウトエンジンは表を壊さないようにテキストサイズを縮小するか、行を丁寧に折り返す必要があります。
スキャンノイズと回転による歪み
物理的なページが完璧にスキャンされることはほとんどありません。本の綴じ付近の湾曲、低コントラスト、ページ角度の傾き、手書きのメモは視覚的ノイズを生み、OCRの読み誤りにつながって誤訳を招きます。
スキャンされたPDFを翻訳する4つの実践的な方法
ドキュメントのデザインの複雑さ、サイズ、そして最終ファイルを編集可能なままにする必要があるかどうかによって、翻訳のアプローチを選びましょう。
方法1: 高度なOCRを備えたインテリジェントなPDF翻訳ツールを使う
ページレイアウトを一致させる必要がある、スキャンされたユーザーマニュアル、段組みの報告書、スキャンされた書籍、領収書、技術データシート。
OCRに対応したインテリジェントなPDF翻訳ツールは、パイプライン全体を処理します。スキャンページの傾き補正、段の分割、テキスト文字列の抽出、文脈を深く考慮したモデルによる翻訳、そして一致するPDFレイアウトの再構築です。
手動のファイル変換工程が不要になるため、最も効率的な方法です。最良の結果を得るには、コントラストの高いスキャンデータを使いましょう。また、全体を処理する前に、ページ範囲指定を使って表や段組みの両方を含む代表的な小さなセクションでテストし、レイアウトの忠実度を確認してください。
手順
- 1スキャンしたPDFをPDF翻訳ツールに直接アップロードします。
- 2OCR処理モジュールを有効にし、翻訳先の言語を選択します。
- 3カスタムのフォントフォールバックルール(アジア言語や中東言語に対するNoto Sansのマッピングなど)を設定します。
- 4ページ範囲を指定して、ファイルの必要な部分だけを対象に翻訳します。
- 5翻訳ツールを実行し、書式の位置合わせを監査して高精細な翻訳PDFを書き出します。
- PDFファイルがアップロードのサイズ上限を超えないようにし、必要ならページを圧縮しましょう。
- 極めて複雑な表がある場合は、そこだけを独立したページ範囲として翻訳します。
方法2: 重要なページを高解像度の画像として抽出する
視覚的に複雑な図面、非常に詳細な単一ページの構成図、方向ラベルが密集した地図。
ドキュメントが非常に複雑な単一ページのレイアウトで構成されている場合、PDFとして翻訳すると重要な背景要素が失われることがあります。その場合は、対象ページをロスレスのPNG画像として書き出し、画像翻訳ツールで処理します。
この方法は、高度な視覚インペインティングを活用して古いラベルを消去し、図面の背景の上に直接翻訳を組版します。単一ページのファイルでは高い信頼性がありますが、複数ページのドキュメントでは作業が煩雑になります。
手順
- 1スキャンしたPDFの重要なページを高解像度のPNG画像に変換します。
- 2その画像をレイアウト保持型の画像翻訳ツールにアップロードします。
- 3翻訳先の言語を選び、標準的な翻訳モデルを設定します。
- 4背景のグラフィックとラベルが正しく配置されているか、視覚的なレイアウトを確認します。
- 5翻訳された画像をダウンロードし、必要に応じて複数ページのPDFドキュメントに再構成します。
方法3: OCRを実行し、編集可能なDOCXまたはMarkdownに変換する
ページレイアウトよりもテキストの編集しやすさが重要な、コンテンツ中心の編集ワークフロー、法務ドラフト、リサーチ分析。
翻訳テキストを編集・注釈付け・配布することが主目的なら、元のPDFのページ構造を厳密に保つことは逆効果です。代わりに、OCRエンジンを使ってスキャンドキュメントを構造化されたMicrosoft Word(DOCX)またはMarkdownファイルに変換します。
変換後はそのファイルを直接翻訳できます。このワークフローなら、翻訳されたテキストがスキャン由来の固定座標ボックスに縛られず、ページをまたいで自然に流れます。契約書、原稿、報告書に最適です。
手順
- 1スキャンしたPDFをOCRで処理し、構造化されたWord(DOCX)またはMarkdownファイルとして書き出します。
- 2書き出したファイルを開き、残っている文字認識エラーや段の結合ミスを修正します。
- 3整形済みのドキュメントをドキュメント翻訳ツールにアップロードします。
- 4見出し、リスト、表、ハイパーリンクを保ったままドキュメントを翻訳します。
- 5翻訳ファイルを書き出し、レイアウトの最終調整を行って必要に応じて配布します。
方法4: 自動のAI翻訳と手動のベクター組版を組み合わせる
プレミアムなパンフレット、製品カタログ、影響の大きい顧客向けのスキャン資料。
価値の高いビジネスアセットでは、自動のレイアウト再構築は優れた出発点のドラフトになります。スキャンドキュメントをプログラムで翻訳した後、翻訳済みのテキスト文字列を書き出し、グラフィックデザイナーやDTP担当者に渡します。
専門家による確認は用語、意味、レイアウトの点検に役立ちますが、誤りがないことや法令適合を保証するものではありません。重要な内容は適切な資格を持つ専門家に確認してください。
手順
- 1高度なツールを使って、PDFの自動翻訳ドラフトを生成します。
- 2翻訳済みのテキスト文字列をExcelまたはXLIFFの翻訳メモリファイルに抽出します。
- 3グラフィックの専門家が、承認済みの翻訳文字列をネイティブのベクターデザインファイルに取り込みます。
- 4翻訳先言語の文字列の膨張に合わせて、テキストボックス、行送り、トラッキングを手動で調整します。
- 5最終的な高品位PDFアセットをコンパイルして書き出します。
モバイル端末でスキャンPDFを翻訳する方法
モバイル端末でスキャンドキュメントを扱うには、ブラウザベースの効率的なワークフローが必要です。重いデスクトップアプリのインストールは避け、OCRと書式処理をブラウザ内で動的にこなすレスポンシブなクラウド翻訳ポータルを活用しましょう。
スマートフォンのカメラでページを取り込むときは、ドキュメントスキャンアプリを使って自動トリミング、コントラスト調整、傾きの補正を行ってから翻訳用にアップロードしてください。
- 1モバイルのWebブラウザでレスポンシブなPDF翻訳ツールを開きます。
- 2ファイルアプリからスキャンドキュメントを選ぶか、クラウドストレージから取り込みます。
- 3翻訳先の言語を選択し、OCRによる翻訳を有効にします。
- 4不要な処理時間とモバイルのメモリ消費を避けるため、必要なページ範囲を指定します。
- 5翻訳を実行し、構造化されたPDFをダウンロードして、拡大表示で表の位置合わせを確認します。
スキャンPDF翻訳の進め方を選ぶ
ドキュメントのレイアウトの複雑さと編集の要件を、最適なOCRおよび翻訳ワークフローに当てはめましょう。
| 状況 | 最適な選択 | 理由 |
|---|---|---|
| ページレイアウトのある複数ページの報告書やスキャン書籍を翻訳する | インテリジェントなPDF OCR翻訳ツール | 傾き補正、段組みのレイアウト解析、翻訳、PDFの再構築を自動化します。 |
| 単一ページの技術図面や視覚要素の多い地図を扱う | 画像抽出+画像翻訳ツール | 視覚インペインティングで古いラベルを消し、グラフィックの上に直接組版します。 |
| 翻訳テキストを積極的に編集、追記、再構成する必要がある | DOCXへのOCR変換+ドキュメント翻訳ツール | 固定された画像の境界を、流れるようで編集可能な段落と表のセルに変えます。 |
| 重要なコーポレートパンフレットやブランド上重要なカタログをローカライズする | AI翻訳ドラフト+ベクター組版 | 完璧なコーポレートタイポグラフィ、ブランドフォントの一貫性、プロの仕上がりを確保します。 |
仕上がりを良くするコツ
ページの傾き補正を徹底する
スキャンしたページは必ずまっすぐにしておきましょう。傾いたスキャンはテキスト行を歪め、レイアウトのセグメンテーションエンジンを乱して翻訳の順序を狂わせます。
翻訳先スクリプトのフォントフォールバックを設定する
非ラテン文字(アラビア語、タイ語、CJK)に翻訳するときは、空の表示ブロック(豆腐文字)を防ぐため、レイアウトエンジンが適切なフォントフォールバックに対応しているか確認しましょう。
必要なページ範囲に絞る
特定の章だけが必要なら、数百ページのドキュメント全体を翻訳しないでください。範囲を絞れば処理が速くなり、翻訳コストも下がります。
段組みの境界をレビューする
段のテキストが隣のブロックへ横方向にはみ出していないか確認しましょう。並列の読み取り構造が壊れている場合は、段落の順序を元のスキャンと照合してください。
数値の整合性と単位を検証する
スキャンノイズは数値を誤読しがちです(「8」を「B」、「1」を「I」と読むなど)。価格、技術的な寸法、仕様は必ず元データと照合しましょう。
表セル内の折り返しを確認する
テキストの膨張により、翻訳語が狭い表の境界内で新しい行に折り返されることがよくあります。表を読みやすく保つため、列幅を広げるかフォントスケールを調整しましょう。
低コントラストのスキャンノイズを取り除く
背景の影、汚れ、綴じ部分の裏写りは、句読点や意味のない文字として誤読されやすくなります。品質の低いスキャンは前処理で背景をきれいにしましょう。
構造化された翻訳キャッシュを維持する
繰り返し発生するドキュメントには翻訳メモリとキャッシュを活用しましょう。用語の一貫性が保たれ、同じ定型セクションを二重に翻訳するコストも避けられます。
よくある質問
翻訳したスキャンPDFでテキストを検索したり選択したりできないのはなぜですか?
元のPDFが生の画像スキャンで、基本的なオーバーレイ型のエンジンで翻訳された場合、ファイルは画像ベースのままです。当社の高度なPDF OCR翻訳ツールは、描画された文字の背後に見えないテキストレイヤーを埋め込むため、ローカライズ後のPDFも検索・選択が完全に可能です。
PDFエンジンは複雑な左右段組みのレイアウトをどのように扱いますか?
エンジンはレイアウト解析モデルを実行し、ページの縦の区切り、画像の境界、ブロック領域を特定します。テキストを論理的なツリーに構造化してから段落を翻訳モデルに渡すため、段は横方向に結合されず、それぞれ連続した流れとして翻訳されます。
翻訳先の言語が元の表のセルに収まらない場合はどうなりますか?
英語からヨーロッパの言語に翻訳するとき、テキストの膨張はよくある問題です。翻訳エンジンは自動フィットのアルゴリズムでフォントスケールを動的に縮小するか、セルの境界内で行を折り返して、表の位置合わせを保ちます。
パスワードで保護されたスキャンPDFを翻訳するにはどうすればよいですか?
OCRを実行するにはドキュメントのラスタデータへのアクセスが必要です。翻訳用にアップロードする前に、PDFからユーザーパスワードとオーナーパスワードを解除してください。アップロード前にファイルの権限を確認しましょう。
一部の非ラテン文字(アラビア語や日本語など)が空の四角で表示されるのはなぜですか?
これは「豆腐」と呼ばれるフォントマッピングのエラーです。PDFビューアに互換性のあるUnicodeフォントがない場合に起こります。当社のPDFエンジンは適切な書体(Noto Sans ArabicやNoto Sans CJKなど)をファイルに直接埋め込むため、どの端末でもグリフが正しく表示されます。
スキャンPDFのアップロードにページ数の上限はありますか?
上限はご契約のプランによって異なります。非常に長いドキュメントでは、ページ範囲指定を使って論理的なまとまりごとに翻訳することをおすすめします。処理が速くなり、レビューも簡単になります。
スキャンドキュメントから構造化データを引き出す
スキャンされたPDFの翻訳を成功させるには、ドキュメント構造とレイアウト再構築への深い理解が必要です。標準的なプレーンテキスト抽出では書式が失われ、基本的なオーバーレイでは段組みや表に対応できません。
高度なOCRによるレイアウト分割、文脈を考慮するLLM、そして的確なフォントフォールバックの埋め込みを組み合わせれば、元のデザインの階層を尊重しつつ、読みやすくプロフェッショナルで検索可能な翻訳PDFを作り出せます。