โดย ImageTranslate · นโยบายบรรณาธิการ
วิธีแปลเอกสารโดยไม่สูญเสียรูปแบบ
คำตอบสั้น
แปลงไฟล์ DOCX, TXT หรือ Markdown ต้นฉบับโดยตรง เพื่อรักษารูปแบบ ตารางซ้อน รายการ และไฮเปอร์ลิงก์ ยอมรับการเปลี่ยนแปลงที่ติดตามไว้ แก้ไขความคิดเห็น และทำความสะอาดเอกสารต้นฉบับก่อนอัปโหลดเสมอ เพื่อป้องกันบริบทของ AI เสียหาย
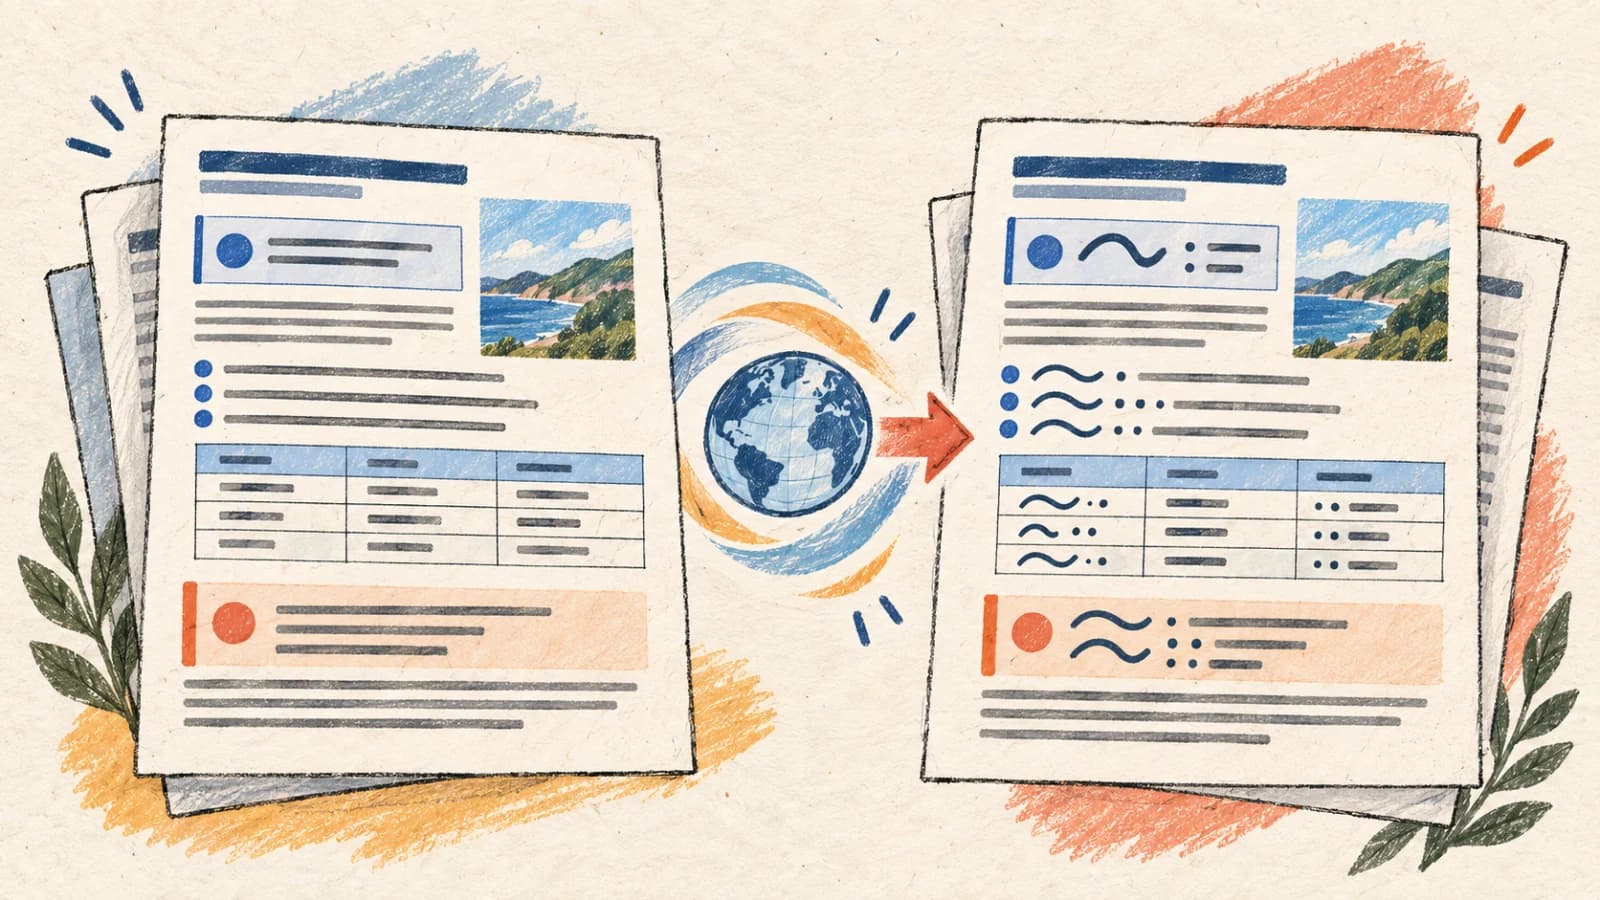
การแปลเอกสารที่มีโครงสร้างไม่ควรต้องคัดลอกย่อหน้าไปใส่ในกล่องข้อความพื้นฐานด้วยตนเอง แม้แนวทางนี้จะแปลคำได้ แต่จะตัดหัวข้อ ตาราง ไฮเปอร์ลิงก์ บล็อกโค้ด รายการ และการจัดรูปแบบเลย์เอาต์หน้าออกไป การสร้างโครงสร้างการจัดรูปแบบเหล่านี้ขึ้นใหม่ด้วยตนเองหลังการแปลใช้เวลามหาศาล
เมื่อคุณต้องทำให้รายงาน คู่มือ ข้อเสนอ ต้นฉบับ หรือคู่มือนโยบายเป็นภาษาท้องถิ่น คุณต้องอัปโหลดรูปแบบเอกสารต้นฉบับโดยตรง ตัวแปลเอกสารจะแยกวิเคราะห์ไฟล์โดยใช้ตัวแยกวิเคราะห์โครงสร้าง AST (Abstract Syntax Tree) และ OpenXML เพื่อแปลเนื้อหาข้อความโดยยังคงแท็กการจัดรูปแบบ โครงสร้างตาราง และรูปแบบทั้งหมดไว้ครบถ้วน
คู่มือเชิงเทคนิคนี้จะอธิบายว่าทำไมรูปแบบจึงเปลี่ยนไประหว่างการแปล เปรียบเทียบขั้นตอนการทำงานแบบอัตโนมัติและด้วยตนเอง แนะนำขั้นตอนการปรับแต่งสำหรับมือถือ และให้รายการตรวจสอบก่อนและหลังการแปล
ประเด็นสำคัญ
- แปลงไฟล์ DOCX, TXT หรือ Markdown ต้นฉบับโดยตรง เพื่อรักษารูปแบบ ตารางซ้อน รายการ และไฮเปอร์ลิงก์
- ยอมรับการเปลี่ยนแปลงที่ติดตามไว้ แก้ไขความคิดเห็น และทำความสะอาดเอกสารต้นฉบับก่อนอัปโหลดเสมอ เพื่อป้องกันบริบทของ AI เสียหาย
- ไฟล์ Markdown และ TXT ดิบมีประสิทธิภาพสูงสำหรับขั้นตอนการทำงานที่เน้นเนื้อหา ซึ่งการจัดรูปแบบหน้าถูกแยกออกจากเนื้อหา
- การแปล PDF ควรสงวนไว้สำหรับการเผยแพร่แบบอ่านอย่างเดียวที่เลย์เอาต์ต้องถูกล็อกอย่างสมบูรณ์
- แยกการตรวจสอบคุณภาพของคุณเป็นรอบการแปลภาษาและรอบการตรวจสอบเลย์เอาต์ภาพ เพื่อให้มั่นใจในความถูกต้อง
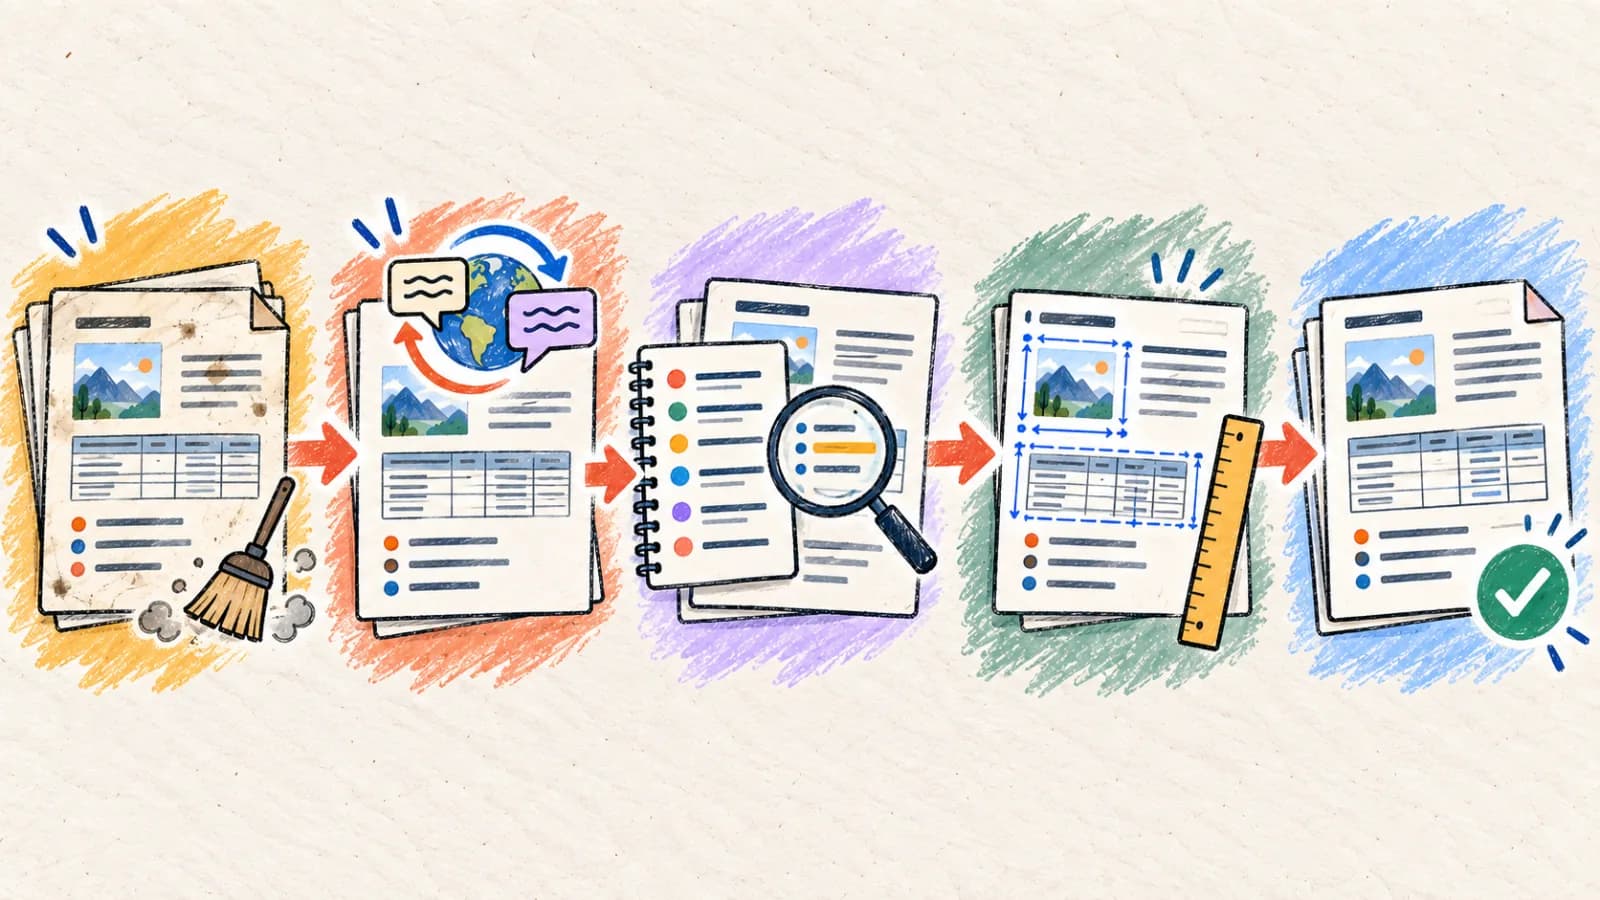
ทำไมรูปแบบเอกสารจึงเปลี่ยนไปหลังการแปล?
ไฟล์เอกสารคือทรีที่ซับซ้อนของการรันข้อความ รูปแบบ การอ้างอิง และเซลล์ตาราง การแปลด้วยเครื่องต้องนำทางโครงสร้างข้อมูลนี้โดยไม่ทำให้แท็กการจัดรูปแบบเสียหาย
การขยายตัวของคำทำให้การไหลของหน้าเปลี่ยนไป
ข้อความแปลอาจใช้พื้นที่มากขึ้นหรือน้อยลงตามภาษาและถ้อยคำ โปรดตรวจสอบผลลัพธ์จริงและปรับขนาดตัวอักษร ระยะห่าง หรือระยะขอบตามความจำเป็น
การแตกหักของการรัน XML
คำหนึ่งคำในไฟล์ DOCX อาจถูกแยกข้ามแท็ก XML หลายตัวจากการตรวจตัวสะกด การเปลี่ยนรูปแบบ หรือการแก้ไขที่ติดตามไว้ ตัวแยกวิเคราะห์พื้นฐานจะตัดโครงสร้างประโยคที่ขอบเขตเหล่านี้ ทำให้การแปล AI แตกกระจายและไม่ถูกต้อง
ขอบเขตเซลล์ตารางที่เข้มงวด
เซลล์ตารางมีขอบเขตแนวนอนที่ตายตัว เมื่อเนื้อหาที่แปลแล้วขยายตัว จะบังคับให้ข้อความตัดบรรทัดอย่างแน่น สร้างเซลล์ที่สูงขึ้น ส่วนหัวคอลัมน์ที่พัง และเลย์เอาต์ตารางที่อ่านไม่ได้ เว้นแต่จะปรับมาตราของการจัดรูปแบบ
ฟิลด์ไดนามิกและรายการที่สร้างอัตโนมัติ
สารบัญ หมายเลขหน้า การอ้างอิงดัชนีไดนามิก และเชิงอรรถ พึ่งพาฟิลด์ของระบบ การแปลด้วยโปรแกรมต้องแยกองค์ประกอบโครงสร้างเหล่านี้ออก โดยแปลเฉพาะข้อความที่มองเห็นและรักษาโครงสร้างฟิลด์เบื้องหลังไว้
การบวมจากการติดตามการเปลี่ยนแปลงและความคิดเห็น
เอกสารที่มีการแก้ไขที่ยังไม่ได้ตัดสินใจ การรันข้อความที่ถูกลบ หรือความคิดเห็นของบรรณาธิการ จะมีประโยคเดียวกันหลายเวอร์ชันซ้อนทับกัน การแปลสิ่งเหล่านี้โดยตรงทำให้ผลลัพธ์ซ้ำซ้อนและสับสน
สี่วิธีในการแปลเอกสาร
เลือกวิธีการแปลเอกสารตามรูปแบบไฟล์เป้าหมาย ความต้องการในการแก้ไข และขนาดของงานแปล
วิธีที่ 1: แปลไฟล์ DOCX, TXT หรือ Markdown ต้นฉบับ
รายงาน คู่มือองค์กร คู่มือการใช้งาน ต้นฉบับ สัญญา และเอกสารทางเทคนิคที่ข้อความต้องแก้ไขได้อย่างสมบูรณ์
ตัวแปลเอกสารที่เข้าใจ AST จะแยกวิเคราะห์โครงสร้างไฟล์ของเอกสาร (เช่น OpenXML ของ Word หรือทรี AST ของ Markdown) แยกข้อความออกมา แปลด้วยโมเดลที่เข้าใจบริบท แล้วแทนที่ข้อความในตำแหน่งเดิม ซึ่งรักษาหัวข้อทั้งหมด โครงสร้างตาราง รายการสัญลักษณ์หัวข้อย่อย และโหนดไฮเปอร์ลิงก์ไว้
นี่เป็นวิธีที่มีประสิทธิภาพที่สุดเพราะไฟล์ผลลัพธ์ยังคงแก้ไขได้และมีการจัดรูปแบบครบถ้วน เพื่อคุณภาพที่ดีที่สุด ให้ทำความสะอาดไฟล์ต้นฉบับโดยแก้ไขการเปลี่ยนแปลงที่ติดตามไว้และความคิดเห็นของบรรณาธิการทั้งหมดก่อนอัปโหลดเพื่อแปล
ทีละขั้นตอน
- 1เปิดเอกสารต้นฉบับของคุณ ยอมรับการเปลี่ยนแปลงที่ติดตามไว้ทั้งหมด แก้ไขความคิดเห็น และลบเลเยอร์การจัดรูปแบบที่ไม่ได้ใช้
- 2อัปโหลดไฟล์ DOCX หรือ Markdown ที่สะอาดไปยังตัวแปลเอกสารโดยตรง
- 3เลือกภาษาเป้าหมายและกำหนดแนวทางการแปลมาตรฐานและอภิธานศัพท์เฉพาะทาง
- 4รันการแปลและดาวน์โหลดเอกสารเฉพาะภาษาที่มีการจัดรูปแบบและแก้ไขได้อย่างสมบูรณ์
- 5ตรวจสอบเลย์เอาต์ผลลัพธ์ โดยปรับความกว้างคอลัมน์ตารางและการขึ้นหน้าใหม่เพื่อรองรับข้อความที่ขยายตัว
- ยืนยันว่าไฮเปอร์ลิงก์ทั้งหมดยังใช้งานได้และชี้ไปยัง URL เฉพาะภาษาที่ถูกต้อง
- สำหรับไฟล์ Markdown ตรวจสอบให้แน่ใจว่าบล็อกข้อมูลเมทาดาท่า frontmatter และการจัดรูปแบบบล็อกโค้ดไม่เสียหาย
วิธีที่ 2: แปลงเป็น PDF แล้วแปลเลย์เอาต์ PDF
รายงานองค์กรแบบคงที่ โบรชัวร์ ใบแจ้งหนี้ และคู่มืออ้างอิงที่เลย์เอาต์หน้าต้องถูกล็อกไว้
หากเอกสารสุดท้ายของคุณคือเอกสารประกอบ PDF แบบอ่านอย่างเดียว ซึ่งการรักษาเลย์เอาต์หน้าให้ตรงตามเดิมสำคัญกว่าความสามารถในการแก้ไข คุณสามารถข้ามการแก้ไขเอกสารไปได้ แปลงไฟล์ของคุณเป็น PDF ก่อน แล้วประมวลผลผ่านตัวแปล PDF ที่รักษาเลย์เอาต์
วิธีนี้ล็อกบล็อกข้อความ ตาราง และภาพทั้งหมดไว้ในตำแหน่งเดิม ป้องกันการเปลี่ยนการไหลของหน้าหรือปัญหาการจัดตำแหน่งตาราง แต่ผลลัพธ์สุดท้ายคือ PDF แบบคงที่ และการแก้ไขเลเยอร์ข้อความในภายหลังต้องใช้เครื่องมือ PDF มืออาชีพ
ทีละขั้นตอน
- 1บันทึกเอกสารที่มีการจัดรูปแบบของคุณเป็นไฟล์ PDF มาตรฐาน
- 2อัปโหลด PDF ไปยังตัวแปล PDF ของเราแล้วเลือกภาษาเป้าหมาย
- 3ตรวจสอบเลย์เอาต์ที่แปลแล้ว ยืนยันว่าตาราง ส่วนหัว และส่วนท้ายจัดตำแหน่งถูกต้อง
- 4ยืนยันว่าอักษรแสดงผลถูกต้องและไม่มีการรันข้อความใดถูกตัด
- 5ดาวน์โหลดและจัดจำหน่าย PDF ที่แปลแล้วซึ่งล็อกเลย์เอาต์ไว้
วิธีที่ 3: แยกบล็อกข้อความ แปลแบบโต้ตอบ แล้วประกอบใหม่
ข้อความเทคนิคสั้น แคมเปญโฆษณา และแบบฟอร์มหน้าเดียวที่ต้องการการแก้ไขศัพท์เฉพาะทางที่แม่นยำและโต้ตอบได้
สำหรับเอกสารสั้นที่มีคำศัพท์สำคัญมาก (เช่น แคมเปญโฆษณาหรือแบบฟอร์ม) การแปลทั้งไฟล์อาจเพิ่มขั้นตอนการจัดรูปแบบที่ไม่จำเป็น ให้แยกบล็อกข้อความด้วยตนเองหรือรันผ่านเครื่องมือแปลข้อความแทน
วิธีนี้ให้คุณแปลย่อหน้าแบบโต้ตอบ ทดสอบการเลือกคำศัพท์ต่าง ๆ และปรับแต่งการแปลบนหน้าจอก่อนนำไปใช้ เมื่อเสร็จสิ้นแล้ว คุณจะวางข้อความที่ได้รับอนุมัติกลับเข้าไปในเทมเพลตเอกสารที่มีการจัดรูปแบบของคุณ
ทีละขั้นตอน
- 1แยกบล็อกข้อความจากเอกสารของคุณไปยังตัวแปลข้อความแบบโต้ตอบ
- 2เลือกภาษาเป้าหมายและกำหนดอภิธานศัพท์เฉพาะทางเพื่อให้มั่นใจในความสอดคล้องของแบรนด์
- 3แปลย่อหน้าแบบโต้ตอบ โดยปรับประโยคเพื่อความชัดเจนและความลื่นไหล
- 4วางข้อความเฉพาะภาษาที่ได้รับอนุมัติกลับเข้าไปในเทมเพลตเอกสารหลักของคุณ
- 5ตรวจสอบการจัดรูปแบบเอกสารและจัดจำหน่ายไฟล์ที่เสร็จสมบูรณ์
วิธีที่ 4: ใช้กระบวนการแปล XLIFF / CAT ระดับมืออาชีพ
แคมเปญการทำให้เอกสารเป็นภาษาท้องถิ่นระดับองค์กรที่ใช้เซิร์ฟเวอร์ฐานข้อมูลหน่วยความจำการแปลและการตรวจสอบโดยนักภาษาศาสตร์ที่ได้รับการรับรอง
สำหรับการแปลเอกสารองค์กรขนาดใหญ่ ไฟล์จะถูกประมวลผลด้วยเครื่องมือแปลโดยใช้คอมพิวเตอร์ช่วย (CAT) ระดับมืออาชีพ โครงสร้างโหนดของเอกสารถูกดึงออกเป็นไฟล์ XLIFF มาตรฐาน ซึ่งแยกข้อความออกมาโดยปกป้องแท็กการจัดรูปแบบไว้
นักภาษาศาสตร์มืออาชีพแปลตาราง XLIFF โดยใช้อภิธานศัพท์เฉพาะทางและฐานข้อมูลหน่วยความจำการแปล เมื่อแปลแล้ว ข้อความที่ได้รับอนุมัติจะถูกนำกลับเข้าไปในโครงสร้างเอกสาร ซึ่งรับประกันคุณภาพทางภาษาระดับองค์กร แต่ต้องมีการตรวจสอบเลย์เอาต์ด้วยตนเองในภายหลัง
ทีละขั้นตอน
- 1แปลงเอกสารต้นฉบับของคุณเป็นไฟล์ XLIFF หรือ Excel ที่มีโครงสร้าง
- 2ส่งไฟล์ให้กับนักภาษาศาสตร์ที่ได้รับการรับรอง หรือประมวลผลผ่านแพลตฟอร์มการแปลระดับองค์กร
- 3นำข้อความที่แปลแล้วกลับเข้าไปในรูปแบบเอกสารต้นฉบับ
- 4ตรวจสอบเลย์เอาต์ด้วยตนเอง แก้ไขปัญหาการล้นหน้าหรือการจัดตำแหน่งคอลัมน์
- 5ส่งออกเอกสารที่เสร็จสมบูรณ์และจัดเก็บหน่วยความจำการแปลไว้สำหรับการอัปเดตในอนาคต
วิธีแปลเอกสารบนอุปกรณ์มือถือ
การแปลเอกสารบนอุปกรณ์มือถือสะดวกมากสำหรับการเดินทางเพื่อธุรกิจ แทนที่จะติดตั้งซอฟต์แวร์เดสก์ท็อปที่หนัก ให้ใช้เครื่องมือแปลบนเบราว์เซอร์ที่ตอบสนองได้ดีซึ่งประมวลผลไฟล์บนคลาวด์ได้โดยตรง
เมื่อตรวจสอบเอกสารที่แปลแล้วบนหน้าจอสมาร์ทโฟน ให้ยืนยันว่ารายการ ตาราง และหัวข้อยังอ่านได้ ใช้รูปแบบ PDF หรือ Markdown เพื่อให้ไฟล์แสดงผลสอดคล้องกันบนอุปกรณ์มือถือต่าง ๆ
- 1เปิดตัวแปลเอกสารของเราในเบราว์เซอร์ของสมาร์ทโฟน
- 2อัปโหลดเอกสารของคุณ (DOCX, TXT หรือ Markdown) จากไฟล์หรือพื้นที่จัดเก็บบนคลาวด์
- 3เลือกภาษาเป้าหมายและเริ่มกระบวนการแปล
- 4ซูมเข้าเพื่อตรวจสอบหัวข้อ รายการสัญลักษณ์หัวข้อย่อย ตาราง และไฮเปอร์ลิงก์
- 5ดาวน์โหลดและบันทึกเอกสารที่แปลแล้วคุณภาพสูง พร้อมสำหรับการแชร์
กำหนดแนวทางการแปลเอกสารของคุณ
จับคู่ความต้องการในการแก้ไขและความซับซ้อนของเลย์เอาต์ภาพของเอกสาร กับขั้นตอนการแปลที่มีประสิทธิภาพที่สุด
| สถานการณ์ | ตัวเลือกที่ดีที่สุด | เพราะเหตุใด |
|---|---|---|
| แปลคู่มือ คู่มือการใช้งาน หรือรายงานที่ต้องแก้ไขได้อย่างสมบูรณ์ | ตัวแปลเอกสารอัตโนมัติ (DOCX/Markdown) | ดึงและแปลบล็อกข้อความโดยหัวข้อ รายการ ตาราง และการจัดรูปแบบทั้งหมดยังคงสมบูรณ์ |
| แชร์เอกสารประกอบแบบคงที่หรือเอกสารนโยบายองค์กร | แปลงเป็น PDF + ตัวแปล PDF | ล็อกองค์ประกอบหน้าทั้งหมด ป้องกันการล้นคอนเทนเนอร์และการเปลี่ยนระยะห่างฟอนต์ |
| ทำงานกับข้อความเทคนิคสั้นหรือแคมเปญโฆษณาที่ต้องการถ้อยคำแม่นยำ | ตัวแปลข้อความแบบโต้ตอบ | เปิดให้แปลและแก้ไขคำสำคัญแบบโต้ตอบได้ทันที |
| จัดการแคมเปญการทำให้เอกสารเป็นภาษาท้องถิ่นระดับองค์กรขนาดใหญ่ | กระบวนการแปล XLIFF/Excel CAT | ทำงานร่วมกับหน่วยความจำการแปลมาตรฐานและขั้นตอนการตรวจสอบโดยนักภาษาศาสตร์มืออาชีพได้อย่างราบรื่น |
เคล็ดลับเพื่อผลลัพธ์ที่ดีขึ้น
ทำความสะอาดประวัติเอกสารต้นฉบับ
ควรยอมรับการเปลี่ยนแปลงที่ติดตามไว้ แก้ไขความคิดเห็นของบรรณาธิการ และลบรูปแบบการจัดรูปแบบที่ไม่ได้ใช้ก่อนแปลเสมอ การแก้ไขที่ยังไม่ได้ตัดสินใจทำให้ไฟล์เอกสารแตกหัก ซึ่งทำลายคุณภาพการแปล
ปกป้องแท็กการจัดรูปแบบ Markdown
เมื่อแปล Markdown ให้ตรวจสอบว่าบล็อกโค้ด ตัวทำเครื่องหมายตัวหนา และคีย์ข้อมูลเมทาดาท่า frontmatter ได้รับการปกป้อง โมเดล AI ไม่ควรแปลหรือเปลี่ยนโครงสร้างไวยากรณ์
เผื่อระยะขอบสำหรับการขยายตัวของข้อความ
ข้อความแปลอาจใช้พื้นที่มากขึ้นหรือน้อยลงตามภาษาและถ้อยคำ โปรดตรวจสอบผลลัพธ์จริงและปรับขนาดตัวอักษร ระยะห่าง หรือระยะขอบตามความจำเป็น
ใช้ฟอนต์ที่รองรับ Unicode เป็นมาตรฐาน
เลือกฟอนต์ที่รองรับ Unicode และใช้ข้ามแพลตฟอร์มได้ (เช่น Arial หรือ Noto Sans) ที่รองรับอักษรที่ไม่ใช่ละติน เพื่อป้องกันข้อผิดพลาดในการเรนเดอร์ฟอนต์บนเอกสารเฉพาะภาษา
ตรวจสอบการตัดบรรทัดของคอลัมน์ตาราง
การขยายตัวของข้อความมักบังคับให้คำที่แปลแล้วตัดไปขึ้นบรรทัดใหม่ภายในขอบเขตตารางที่แคบ ควรขยายขีดจำกัดคอลัมน์หรือปรับขนาดฟอนต์เพื่อให้ตารางอ่านได้
ล็อกอภิธานศัพท์เทคนิคและคำศัพท์แบรนด์
ตรวจสอบให้แน่ใจว่าหมายเลขรุ่น รหัส SKU และคำนามแบรนด์ที่มีลิขสิทธิ์ได้รับการปกป้อง สินทรัพย์ที่แปลไม่ได้ต้องคงรูปแบบเดียวกันในเอกสารทุกเวอร์ชันภาษา
ตรวจสอบฟิลด์ไดนามิกและดัชนี
หลังจากแปลไฟล์ DOCX ให้รีเฟรชฟิลด์อัตโนมัติเช่นสารบัญและหมายเลขหน้าใน Word เพื่อให้แน่ใจว่าอัปเดตถูกต้องตามข้อความเฉพาะภาษา
ตรวจสอบการจับคู่หน้าของสารบัญ
เนื่องจากการขยายตัวของข้อความทำให้ขอบเขตหน้าเปลี่ยนไป ควรอัปเดตการจับคู่หน้าของสารบัญก่อนส่งออกเอกสารที่เสร็จสมบูรณ์เสมอ
คำถามที่พบบ่อย
การแปลไฟล์ Word ของฉันจะทำให้รายการสัญลักษณ์หัวข้อย่อยและตารางพังหรือไม่?
ไม่ ตัวแปลเอกสารอัตโนมัติของเราแยกวิเคราะห์โครงสร้างไฟล์เอกสารโดยตรง โดยแยกและแปลเฉพาะโหนดข้อความ ตาราง โครงสร้างรายการ เส้นขอบ และรูปแบบทั้งหมดยังคงสมบูรณ์
ฉันสามารถแปลไฟล์ Markdown ที่มีบล็อกโค้ดและ frontmatter ได้หรือไม่?
ได้ ตัวแยกวิเคราะห์ของเราเข้าใจ AST โดยจะระบุไวยากรณ์การจัดรูปแบบ Markdown โครงสร้างบล็อกโค้ด และคีย์ frontmatter ของ YAML เพื่อให้สิ่งเหล่านั้นได้รับการปกป้องในขณะที่แปลเฉพาะเนื้อหาหลัก
จะเกิดอะไรขึ้นถ้าวลีที่แปลแล้วล้นเซลล์ตารางของฉัน?
ตัวแปลเอกสารจะแยกวิเคราะห์ขอบเขตเซลล์และตัดบรรทัดข้อความอย่างสวยงาม เพื่อป้องกันแถวตารางที่สูงและอ่านยาก คุณสามารถปรับความกว้างคอลัมน์หรือลดขนาดฟอนต์ในโปรแกรมแก้ไขของคุณได้
ฉันจะแปลเอกสารที่มีการเปลี่ยนแปลงที่ติดตามไว้และยังไม่ได้ตัดสินใจได้อย่างไร?
เราแนะนำอย่างยิ่งให้ยอมรับการเปลี่ยนแปลงที่ติดตามไว้ทั้งหมดและแก้ไขความคิดเห็นก่อนอัปโหลด เอกสารที่มีการแก้ไขที่ยังใช้งานอยู่จะมีการรันข้อความซ้อนทับกัน ซึ่งทำลายบริบทการแปลของ AI
ทำไมหัวข้อของฉันจึงตัดไปขึ้นหลายบรรทัดหลังการแปล?
นี่เป็นผลลัพธ์ที่พบบ่อยของการขยายตัวของข้อความ (เช่น การแปลจากอังกฤษเป็นเยอรมันหรือสเปน) คุณสามารถปรับระยะขอบเอกสาร ลดขนาดฟอนต์หัวข้อ หรือใช้ถ้อยคำที่กระชับขึ้นได้
มีขีดจำกัดขนาดไฟล์สำหรับการอัปโหลดเอกสารหรือไม่?
ขีดจำกัดการอัปโหลดขึ้นอยู่กับแผนการสมัครสมาชิกปัจจุบันของคุณ หากไฟล์ของคุณมีภาพหรือสื่อขนาดใหญ่ฝังอยู่ เราแนะนำให้ถอดออกก่อนแปล แล้วค่อยใส่กลับเข้าไปในผลลัพธ์เฉพาะภาษา
รักษาโครงสร้างเอกสารเพื่อผลลัพธ์ระดับมืออาชีพ
การแปลเอกสารให้สำเร็จต้องเข้าใจโครงสร้างไฟล์และการจัดรูปแบบเลย์เอาต์อย่างลึกซึ้ง วิธีคัดลอกและวางแบบมาตรฐานจะตัดการจัดรูปแบบออกไปและนำไปสู่ปัญหาการจัดรูปแบบขนาดใหญ่
ด้วยการใช้ตัวแปลเอกสารอัตโนมัติที่เข้าใจ AST การทำความสะอาดไฟล์ต้นฉบับก่อนประมวลผล และการวางแผนสำหรับการขยายตัวของภาษา คุณสามารถส่งมอบเอกสารที่ทรงพลังและเป็นมืออาชีพ ซึ่งเคารพมาตรฐานเลย์เอาต์ของคุณในทุกภาษา