Por ImageTranslate · Política editorial
Cómo traducir un PDF escaneado y conservar el formato
Respuesta breve
Si no puede seleccionar ni buscar una palabra concreta en su PDF, el documento requiere una cadena de traducción con OCR. Los diseños de PDF de varias columnas (por ejemplo, informes, artículos de investigación) requieren motores inteligentes de agrupación de bloques para evitar traducciones de frases desordenadas.
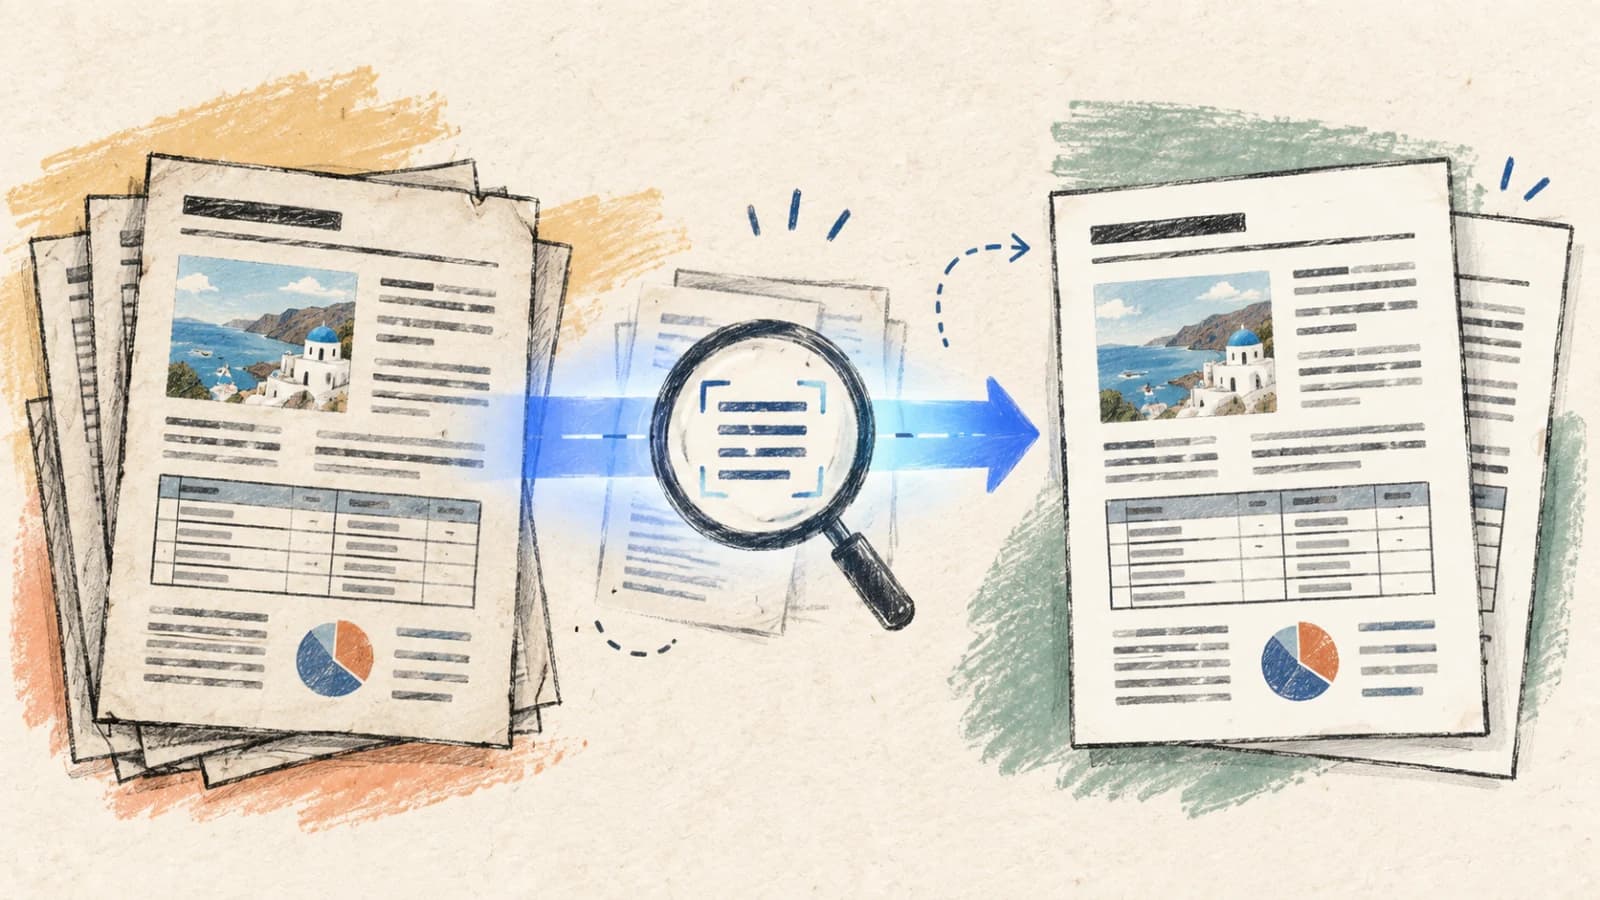
Un PDF escaneado es esencialmente una colección de fotografías digitales de alta resolución agrupadas en un solo archivo. Como no hay una capa de texto subyacente, las operaciones normales de copia de texto fallan, la búsqueda en el documento devuelve cero resultados y los traductores básicos emiten páginas en blanco o errores de formato.
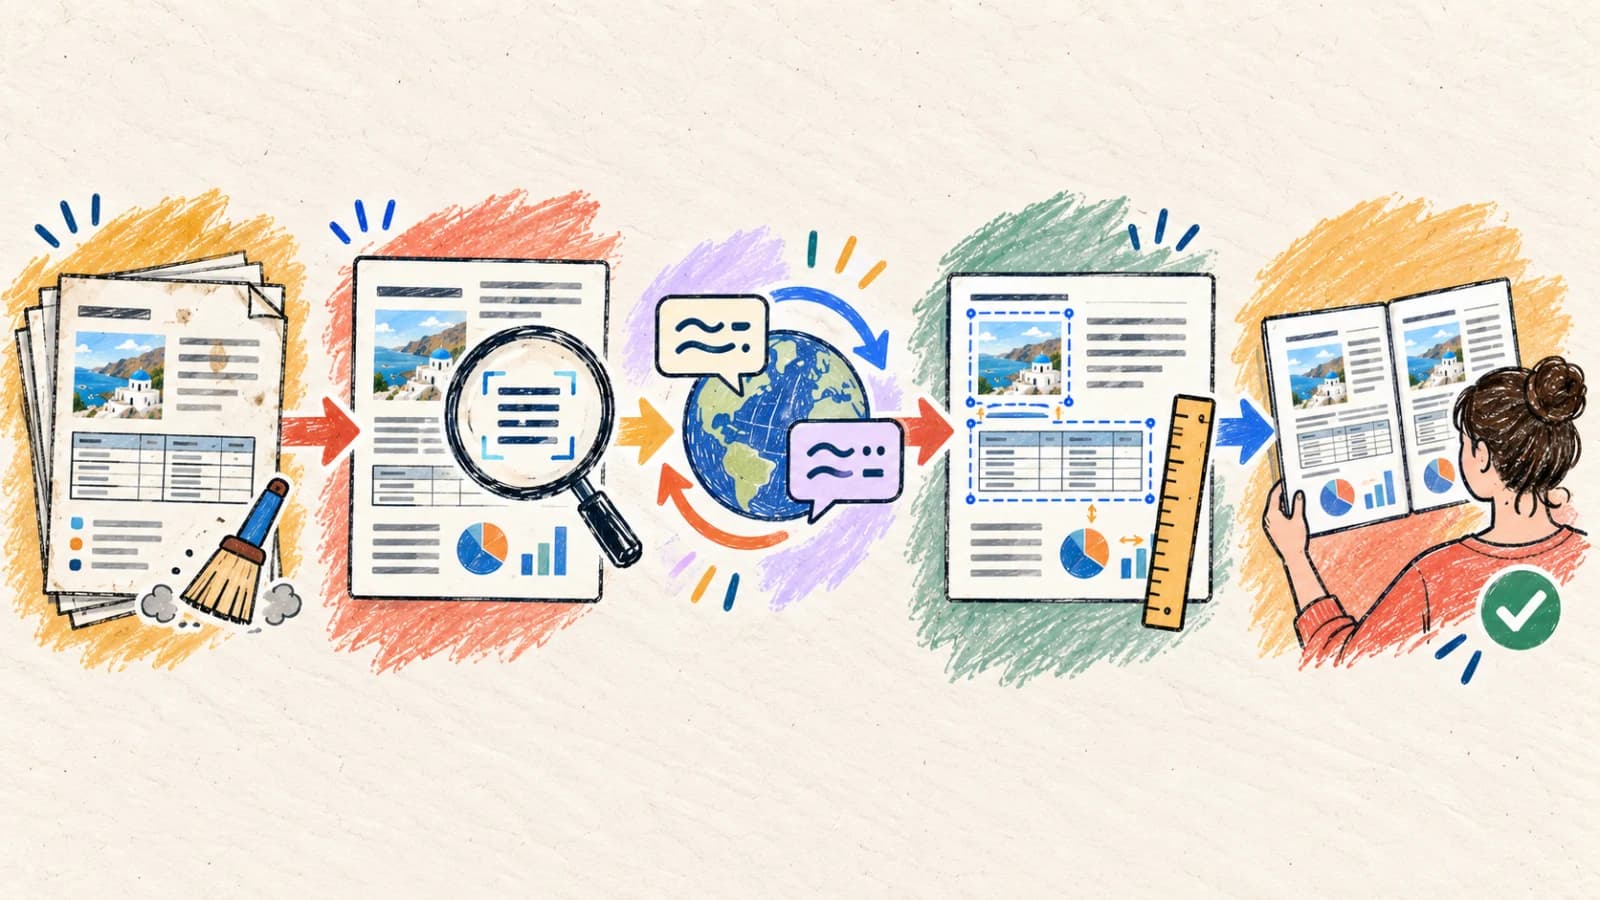
Para traducir un PDF escaneado sin destruir su diseño, debe usar un traductor de PDF con capacidades OCR (Reconocimiento Óptico de Caracteres). La cadena de traducción debe extraer datos de coordenadas espaciales, determinar los flujos de lectura (como diseños de varias columnas), traducir las cadenas con contexto y reconstruir dinámicamente un nuevo archivo PDF. Este proceso también debe incrustar fuentes de respaldo Unicode adecuadas para evitar errores de visualización.
Esta guía completa detalla cómo identificar páginas escaneadas, gestionar diseños de documentos complejos, manejar restricciones tipográficas no latinas y verificar las estructuras finales del documento antes de la entrega.
Puntos clave
- Si no puede seleccionar ni buscar una palabra concreta en su PDF, el documento requiere una cadena de traducción con OCR.
- Los diseños de PDF de varias columnas (por ejemplo, informes, artículos de investigación) requieren motores inteligentes de agrupación de bloques para evitar traducciones de frases desordenadas.
- La integración de fuentes de respaldo es crítica; traducir a idiomas como el árabe, el tailandés, el chino, el japonés o el coreano requiere incrustar tipos de letra compatibles (como Noto Sans) para evitar bloques de glifos rotos.
- Restrinja los rangos de páginas de traducción al procesar documentos multipágina masivos para reducir costes de procesamiento y acortar los tiempos de revisión.
- Preste mucha atención a las estructuras de tabla, las notas al pie y los sellos pequeños, que son muy propensos a rupturas de formato durante la expansión del texto.
¿Por qué es difícil traducir los PDF escaneados?
A diferencia de los documentos nativos, los PDF escaneados no proporcionan vectores de diseño ni caracteres. Reconstruir un documento multipágina idéntico en otro idioma requiere un análisis avanzado del documento.
Falta de una capa de texto estructurado
Un escáner registra una imagen plana de la página. El traductor debe analizar las formas visuales de las letras, ensamblarlas en palabras y párrafos cohesivos y realizar un análisis de diseño antes de traducir los bloques de texto.
Confusión en el orden de lectura de varias columnas
Los artículos académicos, las revistas y los informes financieros usan columnas, barras laterales y cuadros destacados. Los motores OCR simples analizan el texto horizontalmente en toda la página, fusionando columnas independientes y corrompiendo el contexto lingüístico.
Metadatos de mapa de fuentes no latinas ausentes
Al traducir del inglés a idiomas con guiones no latinos (como el árabe, el tailandés o el japonés), el PDF de salida debe incrustar nuevos archivos de mapa de fuentes. Sin fuentes de respaldo adecuadas, los lectores de PDF no pueden mostrar los glifos, lo que da como resultado cuadros vacíos.
Restricciones de límites estrictos en las tablas
Las tablas, los formularios y las especificaciones técnicas tienen límites físicos rígidos. Cuando una frase traducida se expande más allá del ancho original de la celda, el motor de diseño debe reducir el tamaño del texto o ajustar las líneas con elegancia para evitar romper las tablas.
Ruido de escaneo y artefactos de rotación
Las páginas físicas rara vez se escanean perfectamente. La curvatura cerca del lomo del libro, el bajo contraste, los ángulos de página sesgados y las notas manuscritas generan ruido visual, lo que produce lecturas erróneas del OCR que se traducen de forma incorrecta.
Cuatro métodos prácticos para traducir un PDF escaneado
Elija un enfoque de traducción según la complejidad de diseño del documento, su tamaño y si el archivo final debe seguir siendo editable.
Método 1: Usar un traductor inteligente de PDF con OCR avanzado
Manuales de usuario escaneados, informes de varias columnas, libros escaneados, recibos y fichas técnicas donde los diseños de página deben coincidir.
Un traductor de PDF capaz de OCR gestiona toda la cadena: endereza la página escaneada, segmenta las columnas, extrae las cadenas de texto, las traduce con modelos de contexto profundo y reconstruye un diseño PDF coincidente.
Este es el método más eficiente porque elimina los pasos manuales de conversión de archivos. Para obtener los mejores resultados, use escaneos de alto contraste. Use siempre las herramientas de selección de rango de páginas para probar una sección pequeña y representativa (como una página que contenga tanto tablas como columnas) y verificar la fidelidad del diseño antes de procesar el documento completo.
Paso a paso
- 1Cargue su PDF escaneado directamente en el traductor de PDF.
- 2Active el módulo de procesamiento OCR y seleccione el idioma de destino concreto.
- 3Configure reglas de fuentes de respaldo personalizadas (por ejemplo, asignar Noto Sans para idiomas asiáticos o de Oriente Medio).
- 4Especifique un rango de páginas selectivo para aislar y traducir solo las partes necesarias del archivo.
- 5Ejecute el traductor, audite las alineaciones de formato y exporte el PDF traducido de alta definición.
- Asegúrese de que su archivo PDF no supere los límites máximos de tamaño de carga; comprima páginas si es necesario.
- Si algunas tablas son extremadamente complejas, tradúzcalas como rangos de páginas aislados.
Método 2: Extraer páginas clave como imágenes de alta resolución
Planos técnicos visualmente complejos, esquemas de una sola página muy detallados y mapas con etiquetas direccionales densas.
Cuando un documento consta de diseños de una sola página muy complejos, traducir el archivo como PDF a veces puede eliminar elementos de fondo críticos. En su lugar, exporte las páginas de destino como imágenes PNG sin pérdida y procéselas mediante un traductor de imágenes.
Este método aprovecha la eliminación de fondo visual avanzada para borrar las etiquetas antiguas y componer las traducciones directamente sobre el fondo del dibujo. Es muy fiable para archivos de una sola página pero resulta tedioso al gestionar documentos multipágina.
Paso a paso
- 1Convierta las páginas críticas de su PDF escaneado en imágenes PNG de alta resolución.
- 2Cargue las imágenes en el traductor de imágenes que conserva el diseño.
- 3Elija el idioma de destino y configure los modelos de traducción estándar.
- 4Compruebe el diseño visual, asegurando que los gráficos de fondo y las etiquetas se alinean correctamente.
- 5Descargue las imágenes traducidas y, si es necesario, reensámbrelas en un PDF multipágina limpio.
Método 3: Ejecutar el OCR y convertir el documento a DOCX o Markdown editable
Flujos de edición centrados en el contenido, borradores legales e investigación donde la editabilidad del texto es más importante que el diseño de página.
Si su objetivo principal es editar, anotar y distribuir el texto traducido, conservar las estructuras exactas de la página PDF original es contraproducente. En su lugar, use un motor OCR para convertir el documento escaneado primero en un archivo estructurado de Microsoft Word (DOCX) o Markdown.
Una vez convertido, puede traducir el archivo directamente. Este flujo garantiza que el texto traducido fluya de forma natural entre páginas sin quedar confinado a cajas de coordenadas rígidas escaneadas. Es ideal para contratos, manuscritos e informes.
Paso a paso
- 1Procese el PDF escaneado mediante un escáner OCR para exportar un archivo estructurado de Word (DOCX) o Markdown.
- 2Abra el archivo exportado y corrija los errores persistentes de reconocimiento de caracteres o de fusión de columnas.
- 3Cargue el documento depurado en el traductor de documentos.
- 4Traduzca el documento conservando encabezados, listas, tablas y hiperenlaces intactos.
- 5Exporte el archivo traducido, finalice los ajustes de diseño y distribúyalo según sea necesario.
Método 4: Combinar la traducción automatizada por IA con la composición manual de vectores
Folletos premium, catálogos comerciales de productos y materiales escaneados de cara al cliente de consecuencias graves.
Para recursos empresariales de alto valor, la reconstrucción automatizada del diseño sirve como un excelente borrador inicial. Tras traducir el documento escaneado de forma programada, extraiga las cadenas de texto traducidas en bruto y entréguelas a un diseñador gráfico o maquetista.
La revisión profesional ayuda a comprobar la terminología, el significado y el diseño, pero no garantiza la ausencia de errores ni el cumplimiento normativo. Los contenidos importantes requieren revisión por especialistas cualificados.
Paso a paso
- 1Genere un borrador de traducción automatizada del PDF con nuestras herramientas avanzadas.
- 2Extraiga las cadenas de texto traducidas en un archivo de memoria de traducción de Excel o XLIFF.
- 3Haga que un especialista gráfico importe las cadenas de traducción aprobadas en los archivos de diseño vectorial nativos.
- 4Ajuste manualmente las cajas de texto, el interlineado y el seguimiento para encajar con la expansión del idioma de destino.
- 5Compile y exporte el recurso PDF finalizado de alta fidelidad.
Cómo traducir PDF escaneados en dispositivos móviles
Gestionar documentos escaneados en dispositivos móviles requiere un flujo de trabajo optimizado basado en el navegador. Evite las instalaciones pesadas de aplicaciones de escritorio utilizando portales de traducción en la nube responsivos que gestionan el OCR y el formato dinámicamente en el navegador.
Al capturar páginas con la cámara de un teléfono inteligente, utilice una aplicación de escaneo de documentos para recortar automáticamente, ajustar el contraste y enderezar los ángulos antes de cargar el archivo para su traducción.
- 1Abra el traductor de PDF adaptativo en el navegador web de su móvil.
- 2Seleccione su documento escaneado desde Archivos o impórtelo desde el almacenamiento en la nube.
- 3Seleccione su idioma de destino y active la traducción con OCR.
- 4Especifique el rango de páginas requerido para evitar tiempo de procesamiento innecesario y saturación de memoria en el móvil.
- 5Ejecute la traducción y descargue el PDF estructurado, haciendo zoom para revisar las alineaciones de las tablas.
Elija su ruta de traducción de PDF escaneado
Mapee la complejidad del diseño de su documento y los requisitos de edición al flujo óptimo de OCR y traducción.
| Situación | Mejor opción | Por qué |
|---|---|---|
| Traducir informes multipágina o libros escaneados con diseños de página | Traductor inteligente de PDF con OCR | Automatiza el enderezado, el análisis de columnas, la traducción y la reconstrucción del PDF. |
| Trabajar con planos técnicos de una sola página o mapas muy visuales | Extracción de imagen + traductor de imágenes | Aprovecha la eliminación de fondo visual para borrar etiquetas antiguas y componer directamente sobre los gráficos. |
| Necesita editar, añadir o reestructurar activamente el texto traducido | Conversión OCR a DOCX + traductor de documentos | Convierte los límites de imagen rígidos en párrafos fluidos y editables y celdas de tabla. |
| Localizar folletos corporativos críticos o catálogos clave para la marca | Borrador de traducción por IA + composición de vectores | Garantiza una tipografía corporativa perfecta, coherencia con la fuente de marca y diseño profesional. |
Consejos para mejores resultados
Aplique el enderezado de documentos
Asegúrese siempre de que las páginas escaneadas estén rectas. Los escaneos sesgados o inclinados distorsionan las líneas de texto, lo que altera los motores de segmentación de diseño y produce traducciones desordenadas.
Configure fuentes de respaldo para el guión de destino
Al traducir a guiones no latinos (árabe, tailandés, CJK), compruebe si el motor de diseño admite fuentes de respaldo adecuadas para evitar bloques de representación vacíos (caracteres tofu).
Aisle rangos de páginas relevantes
No traduzca documentos enteros de cientos de páginas si solo necesita capítulos concretos. Delimitar el rango de páginas acelera el procesamiento y reduce los costes de traducción.
Revise los límites de varias columnas
Verifique que el texto de las columnas no se desborde horizontalmente hacia los bloques adyacentes. Si las estructuras de lectura lado a lado se rompen, compruebe el orden de los párrafos frente al escaneo de origen.
Verifique la integridad numérica y las unidades
El ruido de escaneo a menudo interpreta mal los números (por ejemplo, leyendo 8 como B o 1 como I). Contrasta todos los precios, las mediciones técnicas y las especificaciones con el origen.
Compruebe el ajuste de palabras en celdas de tabla
La expansión del texto suele forzar a las palabras traducidas a pasar a nuevas líneas dentro de los límites estrechos de la tabla. Amplíe los límites de columna o ajuste las escalas de fuente para mantener las tablas legibles.
Elimine el ruido de escaneo de bajo contraste
Las sombras de fondo, las manchas y la sangre del lomo se interpretan fácilmente como puntuación o caracteres aleatorios. Preprocese los escaneos de baja calidad para limpiar los fondos.
Mantenga cachés de traducción estructurados
Use memoria de traducción y cachés para documentos recurrentes. Esto garantiza una terminología coherente y evita pagar dos veces por traducir secciones de texto fijo idénticas.
Preguntas frecuentes
¿Por qué no puedo buscar ni seleccionar texto en mi PDF escaneado traducido?
Si el PDF de origen era un escaneo de imagen en bruto y se tradujo con motores básicos de superposición, sigue siendo un archivo basado en imágenes. Nuestro traductor avanzado de PDF con OCR inyecta una capa de texto invisible activa detrás de los caracteres representados, haciendo que su PDF localizado final sea totalmente buscable y seleccionable.
¿Cómo gestiona el motor PDF los diseños complejos de columnas lado a lado?
El motor ejecuta un modelo de análisis de diseño que identifica los divisores verticales de página, los límites de imagen y las zonas de bloque. Estructura el texto en un árbol lógico antes de enviar los párrafos al modelo de traducción, asegurando que las columnas se traduzcan como flujos individuales continuos en lugar de fusionarse horizontalmente.
¿Qué ocurre si el idioma de destino no cabe en las celdas originales de la tabla?
La expansión del texto es un problema común al traducir del inglés a idiomas europeos. El motor de traducción reduce dinámicamente la escala de la fuente (usando algoritmos de ajuste automático) o ajusta las líneas dentro de los límites de la celda para mantener las tablas perfectamente alineadas.
¿Cómo puedo traducir un PDF escaneado protegido con contraseña?
Nuestro sistema requiere acceso a los datos rasterizados del documento para ejecutar el OCR. Debe eliminar las contraseñas de usuario y de propietario del archivo PDF antes de cargarlo para su traducción. Compruebe los permisos del archivo antes de cargarlo.
¿Por qué algunos caracteres no latinos (como el árabe o el japonés) se mostraban como cuadros vacíos?
Este es un error de asignación de fuentes conocido como tofu. Ocurre cuando el visor del PDF carece de una fuente Unicode compatible. Nuestro motor PDF incrusta tipos de letra adecuados (como Noto Sans Arabic o Noto Sans CJK) directamente en el archivo, asegurando que los glifos se muestren correctamente en todos los dispositivos.
¿Existe un límite de páginas para cargar PDF escaneados?
Los límites varían según su plan de suscripción. Para documentos extremadamente largos, recomendamos utilizar los controles de rango de páginas para traducir el archivo en lotes lógicos, lo que acelera el procesamiento y simplifica la revisión.
Libere datos estructurados de los documentos escaneados
Traducir PDF escaneados con éxito requiere una comprensión profunda de la estructura del documento y la reconstrucción del diseño. La extracción de texto plano estándar elimina el formato, mientras que las superposiciones básicas no gestionan columnas ni tablas.
Combinando la segmentación avanzada de diseño mediante OCR, los LLM con contexto y la incrustación precisa de fuentes de respaldo, puede producir PDF traducidos muy legibles, profesionales y buscables que respetan la jerarquía de diseño original.