作者 ImageTranslate · 编辑准则
如何为图片、PDF 和文档选择合适的翻译器
直接解答
按文件结构来路由素材:图片需要图像修复,扫描 PDF 需要 OCR,PPTX 需要 XML 对象解析,文档需要语法树解析器。 尽早明确可编辑性要求;不要把 DOCX 或 PPTX 这类可编辑文件在翻译前先转成静态 PDF。
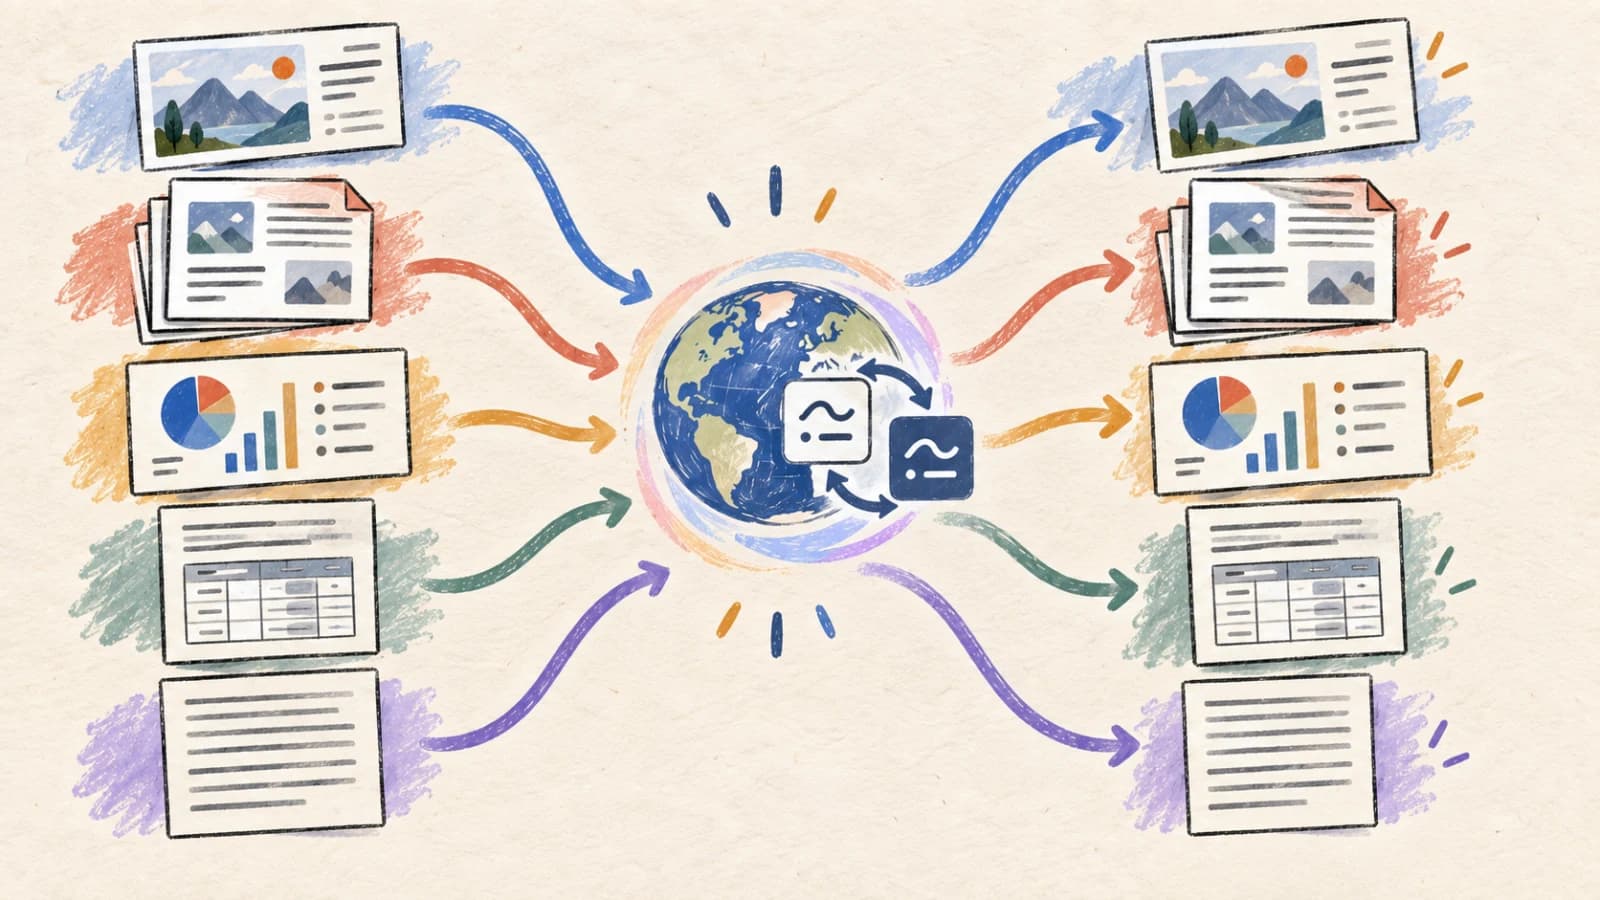
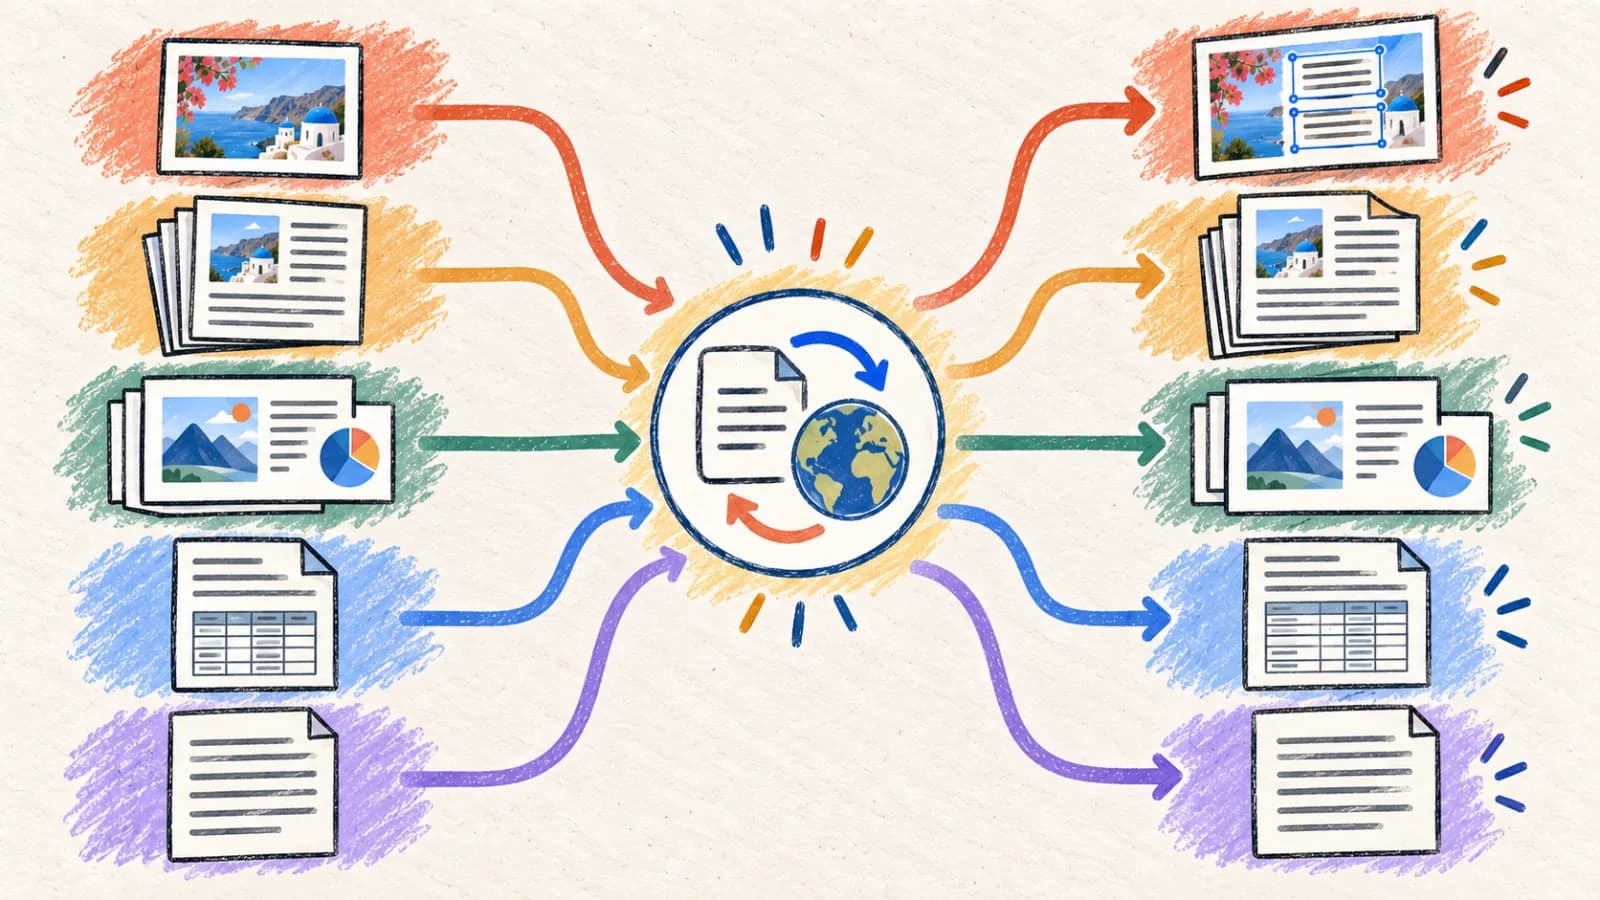
同一句话,可能存在于手机截图里、多页扫描 PDF 里、一套幻灯片里、一份 Microsoft Word 文档里,或一个原始 Markdown 文件里。然而,把这些格式全都塞进同一个纯文本框里处理,效率极低。
把所有素材都硬塞给通用翻译器,会丢掉表格边框、压平可编辑的文字层、忽略演讲者备注,最后留给你数小时的手动排版工作。高质量的本地化要求把每种文件类型路由到专门的翻译引擎——那是为解析并重建该文件结构而设计的引擎。
这份技术指南提供一套架构级决策框架,帮你选择合适的翻译工作流,对比五条核心文件流水线,并说明视觉版式与可编辑性之间的取舍。
核心要点
- 按文件结构来路由素材:图片需要图像修复,扫描 PDF 需要 OCR,PPTX 需要 XML 对象解析,文档需要语法树解析器。
- 尽早明确可编辑性要求;不要把 DOCX 或 PPTX 这类可编辑文件在翻译前先转成静态 PDF。
- 善用页码范围和幻灯片范围选择,先用小样本(如高对比度页面或复杂幻灯片)测试,再翻译大文件。
- 把产品名、URL 和变量锁定在术语表中,防止 AI 模型翻译或破坏它们。
- 让审核流程匹配文档的风险等级:随手截图快速过一遍即可,而安全手册需要双道语言专家审核。
为什么文件类型会决定翻译方法?
文档的技术价值既在文字里,也在结构里。一套成功的翻译工作流,必须保住那些让你的内容可用的关系。
底层数据层各不相同
图片把文字存为原始彩色像素;DOCX 文档存的是可编辑的段落片段和嵌套样式;PowerPoint PPTX 把文字存在有定位坐标的页面对象里;而 PDF 可能包含原生矢量、栅格化图像,或两者兼有。
可编辑性与版式保留之间的取舍
企业路演材料必须保持完全可编辑以便后续修订,而年报讲义通常以静态 PDF 分发。文件路由错了,就可能压平可编辑图层或破坏版式对齐。
依赖版式的上下文含义
在技术示意图和产品图里,标注依赖空间位置(比如一个指向某个部件的箭头)。纯文本翻译会剥掉这些坐标,破坏上下文并导致错误。
文字膨胀与容器溢出
译文所需空间会随语言和措辞变化。请检查实际输出,并按需调整字号、间距或页边距。
风险等级与审核要求各不相同
翻译一张随手拍的旅行路牌风险很低,而翻译安全标识或财务审计则有重大的法律后果。同一套 AI 工具可以为两者生成草稿,但高风险素材必须经过持证人工审核。
按源格式选择翻译器
把素材路由到专门的翻译流水线——那是为解析并重建你这种文件格式的独特版式规则而设计的。
方法一:使用保留版式的 AI 图片翻译器
截图、UI 稿、信息图、系统示意图、营销横幅和产品包装。
自动图片翻译器在一条流水线里协调三套系统:首先由 OCR 模型定位文字外框;其次由基于视觉的图像修复模型把背景上的原文清理干净;第三步由 LLM 翻译文字;最后由画布渲染引擎把译文按匹配的字号、颜色和角度渲染回原位。
这对视觉素材非常高效,因为它完全省去了手动擦除原文和重建设计图层的工作。为保证最佳质量,请务必上传高分辨率文件(PNG 或无损 WebP),并用术语表保护 SKU 编号和品牌名词。
操作步骤
- 1把高分辨率图片直接上传到图片翻译器。
- 2选择目标语言,并配置术语表。
- 3确认背景纹理被修复干净,没有留下视觉痕迹。
- 4检查文字对齐与容器边界,必要时调整缩放比例。
- 5下载本地化的高保真图片素材。
- 裁掉黑边或聊天软件界面,避免把处理资源浪费在无关元素上。
- 确保文字与背景图形之间有足够的对比度,以帮助 OCR 检测。
方法二:使用带进阶 OCR 的智能 PDF 翻译器
多页扫描件或原生报告、图纸、扫描书籍、财务报表和技术参数表。
智能 PDF 翻译器运行一条多阶段的版式分析流水线:对扫描页纠斜、切分竖向分栏、提取文字、结合上下文翻译段落,并重建出匹配的 PDF 版式。它还会嵌入合适的 Unicode 回退字体(如 Noto Sans),避免出现显示错误。
这对多页文件非常可靠。为保证最佳质量,先用页码范围选择工具翻译一小段样本,这样你可以在处理整份文档前,核查版式保真度、分栏边界和表格换行情况。
操作步骤
- 1把 PDF 直接上传到 PDF 翻译器,并选择目标语言。
- 2为扫描页面启用 OCR 模块,并配置目标文字的字体回退。
- 3指定页码范围,只翻译需要的部分。
- 4复核输出版式,检查分栏流向与表格单元格内的换行。
- 5导出最终完全可搜索的翻译版 PDF。
- 确保文件不超过上传大小上限;必要时压缩页面。
- 上传前先移除 PDF 的用户密码和所有者密码保护。
方法三:使用可识别 XML 的自动 PPTX 翻译器
PowerPoint 幻灯片、销售演示、课程课件和企业模板。
可识别 XML 的 PPTX 翻译器会解析你的 PowerPoint 文件,把幻灯片和演讲者备注里的文字原地隔离并翻译。这样能保留所有形状、动画路径、母版版式和图表关联,最终输出一个完全可编辑的 PPTX 文件。
这对演示类素材是最高效的工作流,因为最终文件依然可编辑。翻译器内置自适应文本算法,会动态缩小字号,把膨胀的译文安全地控制在原有视觉边界之内。
操作步骤
- 1把原生 PPTX 演示文稿直接上传到 PowerPoint 翻译器。
- 2选择目标语言,并配置演讲者备注的翻译设置。
- 3先圈定一小段幻灯片范围(例如第 1-3 页)试跑一次,验证版式表现。
- 4运行翻译,在编辑器中打开输出的 PPTX,核查幻灯片设计。
- 5针对内容膨胀的页面调整文本容器宽度或字号,然后保存文件。
- 确认嵌入的图表标签和图例都翻译正确。
- 编辑译后的 PPTX 前,先在本机安装好所有必需的企业品牌字体。
方法四:使用可识别语法树的文档翻译器
需要保留结构的 Microsoft Word DOCX 文件、纯 TXT 和 Markdown 文件。
可识别 AST 的文档翻译器会解析文档底层的文件结构(例如 Word 的 OpenXML 或 Markdown 的 AST 树),隔离出文字并原地替换文本串。这样能完整保留全部标题、表格结构、项目符号列表和超链接节点。
这对企业报告和文档非常高效,因为输出文件依然完全可编辑且带样式。为保证最佳质量,上传前请先清理源文件:处理完所有修订记录和编辑批注。
操作步骤
- 1清理源文档,处理完所有修订记录和批注。
- 2把 DOCX 或 Markdown 文件上传到文档翻译器,并选择目标语言。
- 3配置术语表,保护专有名词和变量。
- 4执行翻译,下载带样式、可编辑的本地化文档。
- 5复核输出版式,调整表格列宽与分页符以应对文字膨胀。
- 对于 Markdown 文件,确认 frontmatter 元数据块和代码语法没有被破坏。
- 确认所有超链接依然有效,并指向正确的本地化 URL。
如何在移动端选择并运行翻译工具
在移动设备上处理不同文件类型,需要一套响应式的云端平台。与其安装笨重的桌面软件,不如使用安全的浏览器门户,在云端直接处理文件。
用手机摄像头取材时,让镜头与被摄面平行,避免倾斜。使用 PDF 或 Markdown 格式,可以确保文件在不同移动设备的视口里显示一致。
- 1在手机浏览器中打开我们的响应式翻译门户。
- 2选择为你的文件类型打造的专用翻译器(图片、PDF、PPT 或文档)。
- 3直接从云端存储或相册上传文件。
- 4指定所需的页码或幻灯片范围,以优化处理时间。
- 5执行翻译并下载本地化素材,放大确认可读性。
文件翻译路由总表
把素材的文件结构与可编辑性要求,对应到为处理它们而设计的专用翻译引擎上。
| 使用场景 | 最佳选择 | 难点 |
|---|---|---|
| 翻译截图、UI 稿、包装设计或视觉横幅 | 保留版式的图片翻译器 | 在一条流水线内自动完成 OCR、背景修复与本地化排版。 |
| 翻译扫描的多页文档、手册或图纸 | 智能 PDF OCR 翻译器 | 对页面纠斜、切分竖向分栏、结合上下文翻译并嵌入字体。 |
| 翻译必须在 PowerPoint 中保持完全可编辑的幻灯片 | 自动 PPTX 翻译器 | 原地解析幻灯片与演讲者备注的 XML 节点,保持版式文件完整。 |
| 翻译带样式的报告、手册或 Markdown 文档文件 | 可识别语法树的文档翻译器 | 自动保留复杂的格式结构、标题、列表、表格和链接。 |
获得更好结果的技巧
从原始格式出发
除非最终交付物确实需要,否则不要把 PPTX 转成 PDF、把 DOCX 转成图片。每一次转换都可能丢掉专用翻译器本可以保留的结构。
先定义最终交付物
想清楚结果必须可编辑、视觉保真、可搜索、可放映,还是只要能看懂就行。这个答案能立刻帮你缩小工作流范围。
先测最难的那个样本
评估翻译工作流时,挑信息最密的幻灯片、多栏 PDF 页、窄表格或低对比度图片,而不是最轻松的第一页。
善用范围选择
页码和幻灯片范围能减少不必要的工作量,让你在处理长文件前先确认术语和版式。
把源文件与译文放在一起
使用清晰的版本命名,并把原始文件与结果存在一起。审核者需要一份可靠的参照,用来核对名称、数字、视觉标注和后续更新。
看清服务的数据条款
上传机密、个人、合同或受监管内容之前,确认其存储、保留、访问和删除条款符合你的要求。
让审核匹配风险
随手截图可能只需要快速看一眼是否通顺;而医疗、法律、财务、安全和公共品牌内容则需要合格的双道人工审核。
避免用一种格式处理所有批次
一个项目文件夹里可能同时有图片、PDF、演示文稿和 Word 文件。把每种源文件路由到它对应的专用工具,再在项目层面汇总审定的输出。
常见问题
翻译图片最好用什么工具?
如果你需要译文出现在成图里,就用保留版式的图片翻译器;如果只是想看懂或复制里面的文字,用 OCR 加文本翻译器就够了。
翻译扫描版 PDF 最好的方式是什么?
使用启用 OCR 的 PDF 翻译器。先用一段有代表性的页面做测试,再对照原始扫描件核查阅读顺序、表格、脚注、印章、人名和数字。
翻译前应该先把 PowerPoint 转成 PDF 吗?
如果结果必须可编辑或要拿去演讲,就保留原始 PPTX。只有当最终产物本身就是一份固定的讲义,且不需要演讲者备注、动画和可编辑对象时,才转成 PDF。
文档翻译比复制文本更好吗?
当标题、列表、表格、链接或“一个可下载的文件”很重要时,文档翻译更好。如果格式无关紧要、只需要其中一小部分,把选中的段落粘进文本翻译器会更快。
所有文件类型都能用同一个翻译器吗?
通用模型也许能把字译出来,但专用工作流保留的是不同的结构:图片保留像素与位置,PDF 保留页面与 OCR,PPTX 保留页面对象与备注,文档保留样式与标题。
什么时候必须引入人工审核?
当错误可能影响安全、健康、法律权利、金钱、技术操作、品牌声誉或公众理解时,就应该引入合格的人工审核。审核者应当看到完整的源文件与带格式的译文,而不是孤立的句子。
选择能保留关键要素的工作流
合适的翻译器,不是那个肯接收你的文字的工具,而是那个足够了解你的文件、能保住受众所需结构的工具:视觉位置、页面、幻灯片对象、文档层级,或者干净的交互式文本。
从原始格式出发,先测最难的样本,并让审核流程匹配风险等级。当一个项目包含多种文件类型时,为每一种都使用它的专用工作流,而不是把所有东西都压平成一个格式。