Autor ImageTranslate · Zasady redakcyjne
Jak przetłumaczyć zeskanowany plik PDF i zachować formatowanie
Krótka odpowiedź
Jeśli nie możesz zaznaczyć ani wyszukać konkretnego słowa w swoim pliku PDF, dokument wymaga procedury tłumaczenia z funkcją OCR. Układy PDF wielokolumnowe (np. raporty, prace badawcze) wymagają inteligentnych silników grupowania bloków, aby zapobiec pomieszaniu tłumaczeń zdań.
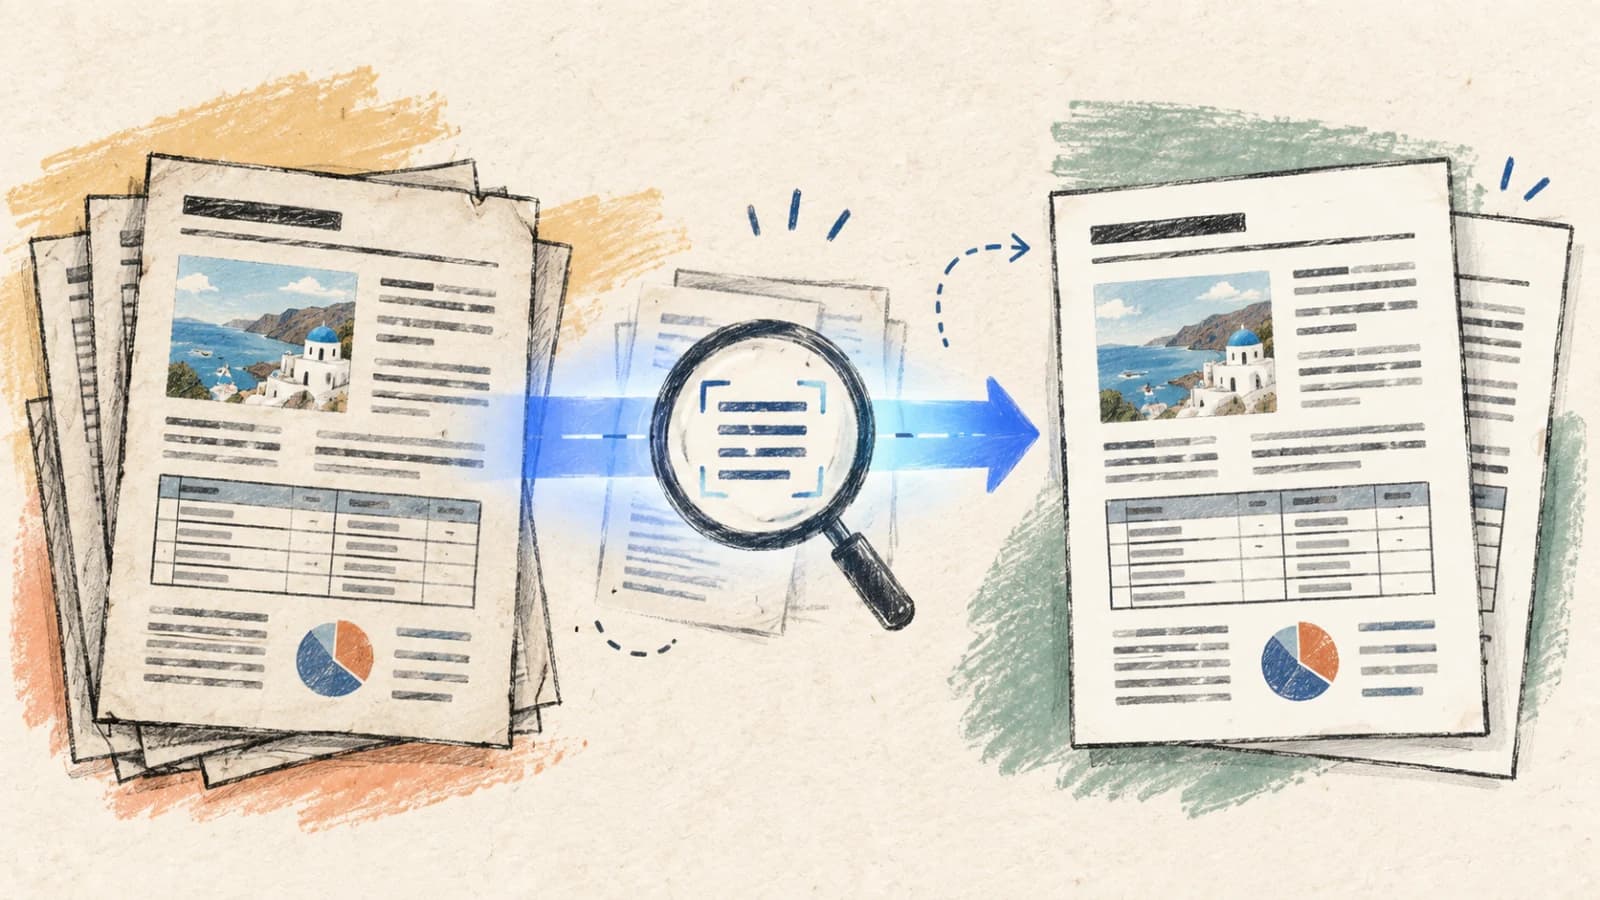
Zeskanowany plik PDF to w zasadzie zbiór zdjęć o wysokiej rozdzielczości połączonych w jeden plik. Ponieważ nie istnieje warstwa tekstu, standardowe operacje kopiowania tekstu zawodzą, wyszukiwanie w dokumencie nie zwraca wyników, a zwykłe tłumacze generują puste strony lub błędy formatowania.
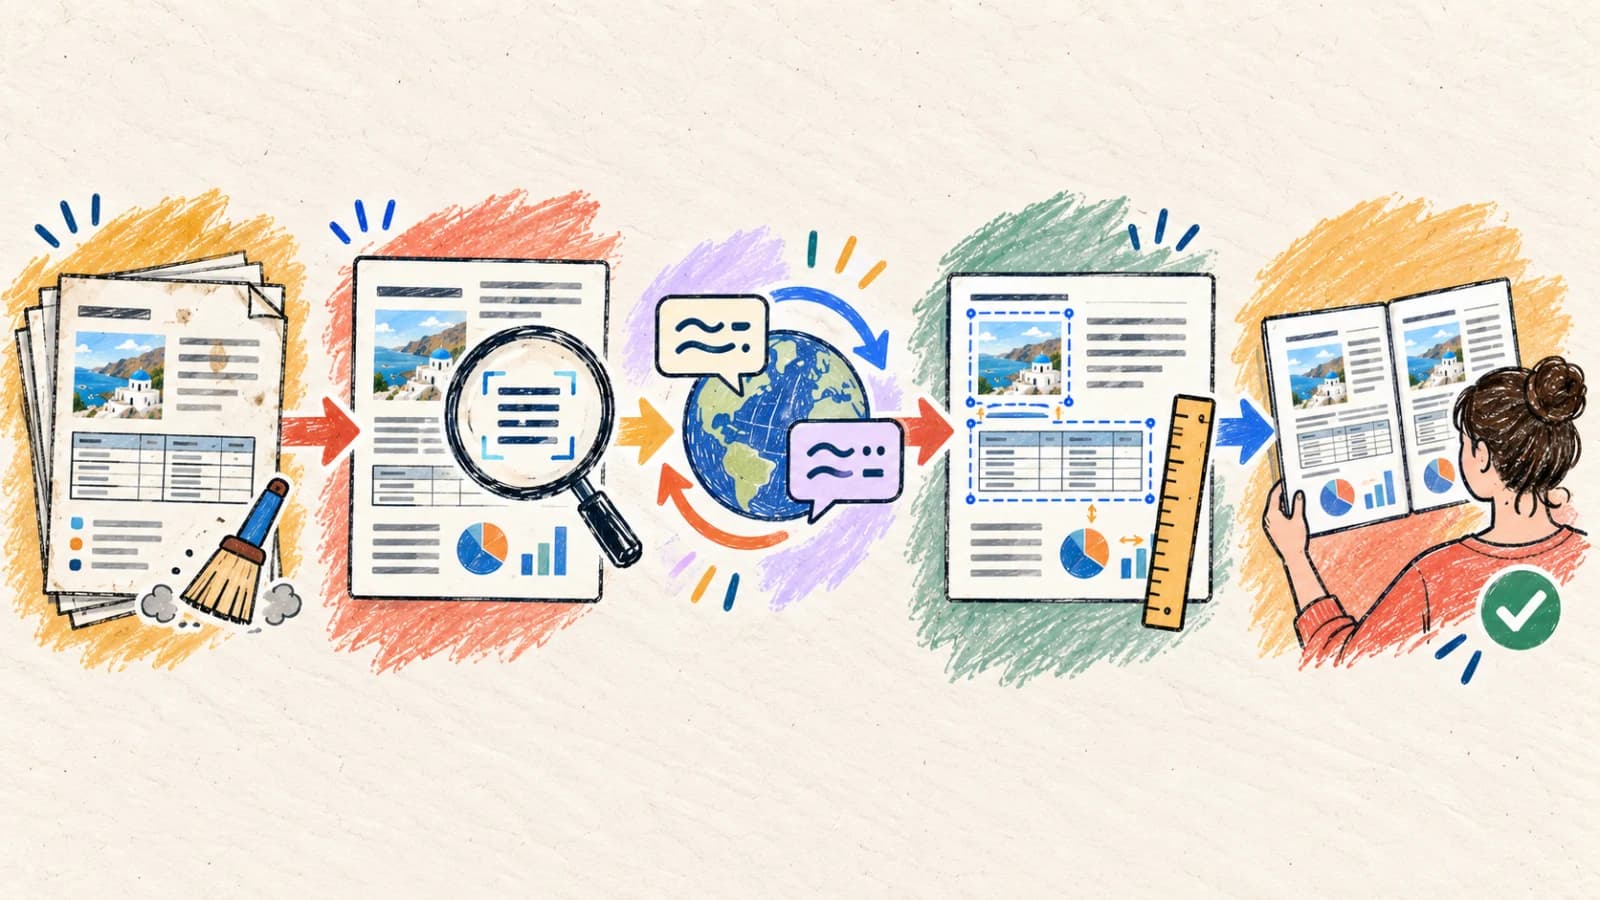
Aby przetłumaczyć zeskanowany plik PDF bez niszczenia układu, potrzebujesz tłumacza PDF z funkcjami OCR (rozpoznawanie optyczne znaków). Procedura tłumaczenia musi wyodrębnić dane współrzędnych przestrzennych, określić przepływy czytania (takie jak układy wielokolumnowe), przetłumaczyć ciągi kontekstowo i dynamicznie odtworzyć nowy plik PDF. Ten proces musi ponadto osadzić odpowiednie czcionki zastępcze Unicode, aby uniknąć błędów wyświetlania.
Ten wyczerpujący przewodnik szczegółowo opisuje, jak identyfikować zeskanowane strony, zarządzać złożonymi układami dokumentów, radzić sobie z ograniczeniami typografii niełacińskiej i weryfikować końcowe struktury dokumentów przed dostarczeniem.
Kluczowe wnioski
- Jeśli nie możesz zaznaczyć ani wyszukać konkretnego słowa w swoim pliku PDF, dokument wymaga procedury tłumaczenia z funkcją OCR.
- Układy PDF wielokolumnowe (np. raporty, prace badawcze) wymagają inteligentnych silników grupowania bloków, aby zapobiec pomieszaniu tłumaczeń zdań.
- Integracja czcionek zastępczych jest kluczowa; tłumaczenie na języki takie jak arabski, tajski, chiński, japoński czy koreański wymaga osadzenia zgodnych czcionek (np. Noto Sans), aby uniknąć uszkodzonych bloków renderowania znaków.
- Ograniczaj zakres stron do przetłumaczenia w przypadku obszernych wielostronicowych dokumentów, aby obniżyć koszty przetwarzania i skrócić czas sprawdzania.
- Zwróć szczególną uwagę na struktury tabel, przypisy i małe pieczątki, które przy rozszerzaniu tekstu są bardzo podatne na pęknięcia formatowania.
Dlaczego zeskanowane pliki PDF są trudne do przetłumaczenia?
W przeciwieństwie do dokumentów natywnych zeskanowane pliki PDF nie oferują wektorów układu ani znaków. Rekonstrukcja identycznego wielostronicowego dokumentu w innym języku wymaga zaawansowanego analizowania dokumentów.
Brak ustrukturyzowanej warstwy tekstowej
Skaner rejestruje płaskie zdjęcie strony. Tłumacz musi przeanalizować wizualne kształty liter, połączyć je w spójne słowa i akapity i przeprowadzić analizę układu, zanim przetłumaczy bloki tekstu.
Zamieszanie w kolejności czytania układów wielokolumnowych
Prace naukowe, magazyny i raporty finansowe używają kolumn, pasków bocznych i pól informacyjnych. Proste silniki OCR analizują tekst poziomo przez całą stronę, zlewając niezależne kolumny i niszcząc kontekst językowy.
Brak metadanych dla map znaków niełacińskich
Przy tłumaczeniu z angielskiego na języki o niełacińskich mapach znaków (takie jak arabski, tajski czy japoński) docelowy plik PDF musi osadzić nowe pliki map znaków czcionek. Bez odpowiednich czcionek zastępczych przeglądarki PDF nie mogą wyświetlić glifów, co skutkuje pustymi prostokątami.
Rygorystyczne ograniczenia granic w tabelach
Tabele, formularze i specyfikacje techniczne mają sztywne fizyczne granice. Gdy przetłumaczone zdanie wykracza poza pierwotną szerokość komórki, silnik układu musi zmniejszyć czcionkę lub elegancko zawinąć wiersze, aby zapobiec pęknięciu tabeli.
Szum skanowania i artefakty rotacji
Fizyczne strony rzadko są skanowane idealnie. Wygięcie przy grzbiecie książki, niski kontrast, pochylone kąty stron i odręczne notatki generują szum wizualny, co prowadzi do błędów OCR, które są następnie błędnie tłumaczone.
Cztery praktyczne metody tłumaczenia zeskanowanego pliku PDF
Wybierz podejście do tłumaczenia na podstawie złożoności projektowej dokumentu, jego rozmiaru i tego, czy plik końcowy musi pozostać edytowalny.
Metoda 1: Użyj inteligentnego tłumacza PDF z zaawansowanym OCR
Zeskanowane instrukcje obsługi, raporty wielokolumnowe, zeskanowane książki, paragony i karty techniczne, w których układy stron muszą się zgadzać.
Inteligentny tłumacz PDF z funkcją OCR przejmuje całą procedurę: prostowanie zeskanowanej strony, segmentację kolumn, ekstrakcję ciągów tekstu, ich tłumaczenie głębokimi modelami kontekstowymi i odtworzenie pasującego układu PDF.
To najbardziej wydajna metoda, ponieważ eliminuje ręczne kroki konwersji plików. Uzyskaj najlepsze wyniki przy skanach o wysokim kontraście. Zawsze używaj narzędzi wyboru zakresu stron, aby przetestować mały, reprezentatywny fragment (np. stronę z tabelami i kolumnami) i zweryfikować wierność układu, zanim przetworzysz cały dokument.
Krok po kroku
- 1Prześlij swój zeskanowany plik PDF bezpośrednio do tłumacza PDF.
- 2Włącz moduł przetwarzania OCR i wybierz konkretny język docelowy.
- 3Skonfiguruj niestandardowe reguły czcionek zastępczych (np. Noto Sans dla języków azjatyckich lub bliskowschodnich).
- 4Określ wybrany zakres stron, aby wyizolować i przetłumaczyć tylko potrzebne części pliku.
- 5Uruchom tłumacz, sprawdź wyrównania formatowania i wyeksportuj przetłumaczony plik PDF o wysokiej rozdzielczości.
- Upewnij się, że plik PDF nie przekracza maksymalnych limitów rozmiaru przesyłania; w razie potrzeby skompresuj strony.
- Jeśli niektóre tabele są ekstremalnie złożone, przetłumacz je jako izolowane zakresy stron.
Metoda 2: Wyodrębnij kluczowe strony jako obrazy o wysokiej rozdzielczości
Bardzo złożone rysunki techniczne, szczegółowe jednostronicowe schematy i mapy z gęstymi opisami kierunkowymi.
Gdy dokument składa się z bardzo złożonych jednostronicowych układów, przetłumaczenie pliku jako PDF może sporadycznie usunąć krytyczne elementy tła. Zamiast tego wyeksportuj docelowe strony jako bezstratne obrazy PNG i przetwórz je przez tłumacza obrazów.
Ta metoda wykorzystuje zaawansowane wizualne wypełnianie (inpainting), aby usunąć stare etykiety i nałożyć tłumaczenia bezpośrednio na tło rysunku. Jest bardzo niezawodna dla plików jednostronicowych, ale staje się uciążliwa przy zarządzaniu wielostronicowymi dokumentami.
Krok po kroku
- 1Skonwertuj krytyczne strony swojego zeskanowanego PDF na obrazy PNG o wysokiej rozdzielczości.
- 2Prześlij obrazy do tłumacza obrazów zachowującego układ.
- 3Wybierz język docelowy i skonfiguruj standardowe modele tłumaczenia.
- 4Sprawdź wizualny układ i upewnij się, że tła graficzne i etykiety są poprawnie wyrównane.
- 5Pobierz przetłumaczone obrazy i w razie potrzeby połącz je w czysty wielostronicowy plik PDF.
Metoda 3: Wykonaj OCR i skonwertuj dokument do edytowalnego DOCX lub Markdown
Przepływy pracy nastawione na treść, projekty prawne i analizy badawcze, w których edytowalność tekstu jest ważniejsza niż układ strony.
Jeśli Twoim głównym celem jest edytowanie, komentowanie i dystrybucja przetłumaczonego tekstu, zachowanie dokładnych pierwotnych struktur stron PDF jest nieproduktywne. Zamiast tego najpierw użyj silnika OCR, aby przekonwertować zeskanowany dokument na ustrukturyzowany plik Microsoft Word (DOCX) lub Markdown.
Po konwersji możesz przetłumaczyć plik bezpośrednio. Ten przepływ pracy zapewnia, że przetłumaczony tekst naturalnie płynie między stronami, bez ograniczeń do sztywnych, zeskanowanych pól współrzędnych. Jest idealny dla umów, rękopisów i raportów.
Krok po kroku
- 1Przetwórz zeskanowany PDF przez skaner OCR, aby wyeksportować ustrukturyzowany plik Word (DOCX) lub Markdown.
- 2Otwórz wyeksportowany plik i popraw pozostałe błędy rozpoznawania znaków lub scalania kolumn.
- 3Prześlij oczyszczony dokument do tłumacza dokumentów.
- 4Przetłumacz dokument, zachowując nagłówki, listy, tabele i hiperłącza.
- 5Wyeksportuj przetłumaczony plik, wprowadź końcowe poprawki układu i rozpowszechniaj zgodnie z potrzebami.
Metoda 4: Połącz zautomatyzowane tłumaczenie AI z ręcznym składem wektorowym
Premiowe broszury, komercyjne katalogi produktów i skierowane do klienta zeskanowane materiały o poważnych konsekwencjach.
W przypadku cennych zasobów biznesowych zautomatyzowana rekonstrukcja układu służy jako doskonała wersja robocza. Po programowym przetłumaczeniu zeskanowanego dokumentu wyeksportuj surowe przetłumaczone ciągi tekstowe i przekaż je grafikowi lub składaczowi.
Profesjonalna weryfikacja pomaga sprawdzić terminologię, znaczenie i układ, ale nie gwarantuje braku błędów ani zgodności z przepisami. Ważne materiały powinny sprawdzać osoby o odpowiednich kwalifikacjach.
Krok po kroku
- 1Wygeneruj zautomatyzowaną wersję roboczą tłumaczenia PDF za pomocą naszych zaawansowanych narzędzi.
- 2Wyeksportuj przetłumaczone ciągi tekstowe do pliku pamięci tłumaczeniowej Excel lub XLIFF.
- 3Pozwól specjaliście graficznemu zaimportować zatwierdzone ciągi tłumaczenia do natywnych plików projektów wektorowych.
- 4Ręcznie dostosuj pola tekstowe, interlinię i śledzenie, aby pomieścić rozszerzanie języka docelowego.
- 5Skompiluj i wyeksportuj sfinalizowany, wysokiej jakości zasób PDF.
Jak przetłumaczyć zeskanowane pliki PDF na urządzeniach mobilnych
Zarządzanie zeskanowanymi dokumentami na urządzeniach mobilnych wymaga zoptymalizowanego, opartego na przeglądarce przepływu pracy. Unikaj instalowania ciężkich aplikacji desktopowych, korzystając z responsywnych portalów tłumaczenia w chmurze, które przetwarzają OCR i formatowanie dynamicznie w przeglądarce.
Przy przechwytywaniu stron aparatem smartfona używaj aplikacji do skanowania dokumentów, aby automatycznie przyciąć, poprawić kontrast i wyprostować kąty, zanim prześlesz plik do tłumaczenia.
- 1Otwórz responsywnego tłumacza PDF w mobilnej przeglądarce internetowej.
- 2Wybierz swój zeskanowany dokument z plików lub zaimportuj z pamięci w chmurze.
- 3Wybierz język docelowy i włącz tłumaczenie wspomagane OCR.
- 4Określ potrzebny zakres stron, aby uniknąć niepotrzebnego czasu przetwarzania i nadmiernego zużycia pamięci mobilnej.
- 5Uruchom tłumaczenie i pobierz ustrukturyzowany plik PDF, powiększając, aby sprawdzić wyrównania tabel.
Wybierz swoją ścieżkę tłumaczenia zeskanowanych plików PDF
Dopasuj złożoność układu dokumentu i wymagania edytowalności do optymalnego przepływu pracy OCR i tłumaczenia.
| Sytuacja | Najlepszy wybór | Dlaczego |
|---|---|---|
| Tłumaczysz wielostronicowe raporty lub zeskanowane książki z układami stron | Inteligentny tłumacz PDF z OCR | Automatyzuje prostowanie, analizę układu kolumn, tłumaczenie i odtworzenie PDF. |
| Pracujesz z jednokolumnowymi rysunkami technicznymi lub silnie wizualnymi mapami | Ekstrakcja obrazu + tłumacz obrazów | Wykorzystuje wizualne wypełnianie, aby usunąć stare etykiety i nałożyć je bezpośrednio na grafiki. |
| Musisz aktywnie edytować, uzupełniać lub restrukturyzować przetłumaczony tekst | Konwersja OCR do DOCX + tłumacz dokumentów | Zamienia sztywne granice obrazu w płynne, edytowalne akapity i komórki tabel. |
| Lokalizujesz krytyczne broszury firmowe lub katalogi o znaczeniu dla marki | Wersja robocza tłumaczenia AI + skład wektorowy | Zapewnia doskonałą typografię firmową, spójność czcionek marki i profesjonalny projekt. |
Wskazówki dla lepszych wyników
Wymuś prostowanie dokumentu
Zawsze upewnij się, że zeskanowane strony są proste. Pochylone lub nachylone skany zniekształcają wiersze tekstu, co zakłóca silniki segmentacji układu i prowadzi do pomieszanych tłumaczeń.
Skonfiguruj czcionki zastępcze dla języka docelowego
Przy tłumaczeniu na niełacińskie mapy znaków (arabski, tajski, CJK) sprawdź, czy silnik układu obsługuje pasujące czcionki zastępcze, aby uniknąć pustych bloków renderowania (znaków tofu).
Izoluj odpowiednie zakresy stron
Nie tłumacz całych stu stronicowych dokumentów, jeśli potrzebujesz tylko konkretnych rozdziałów. Ograniczenie zakresu stron przyspiesza przetwarzanie i obniża koszty tłumaczenia.
Sprawdzaj granice układów wielokolumnowych
Upewnij się, że tekst kolumn nie wylewa się poziomo do sąsiednich bloków. Jeśli sąsiadujące struktury czytania są uszkodzone, sprawdź kolejność akapitów względem źródłowego skanu.
Sprawdzaj integralność liczbową i jednostki
Szum skanowania często błędnie interpretuje liczby (np. z „8” robi „B”, a z „1” robi „I”). Zestaw wszystkie ceny, pomiary techniczne i specyfikacje ze źródłem.
Sprawdzaj zawijanie wierszy w komórkach tabel
Rozszerzanie tekstu często zmusza przetłumaczone słowa do przenoszenia na nowe linie w ciasnych granicach tabel. Rozszerzaj granice kolumn lub dostosuj rozmiary czcionek, aby tabele pozostały czytelne.
Usuwaj szum przy niskim kontraście
Cienie tła, plamy i przebicia od grzbietu książki są łatwo mylone ze znakami interpunkcyjnymi lub losowymi znakami. Przetwórz wstępnie słabej jakości skany, aby oczyścić tła.
Prowadź ustrukturyzowane pamięci tłumaczeniowe
Używaj pamięci tłumaczeniowych i pamięci podręcznych dla powtarzających się dokumentów. To zapewnia spójność terminologii i unika podwójnych kosztów tłumaczenia identycznych standardowych sekcji.
Często zadawane pytania
Dlaczego nie mogę wyszukiwać ani zaznaczać tekstu w moim przetłumaczonym zeskanowanym PDF?
Jeśli źródłowy plik PDF był surowym skanem obrazu i został przetłumaczony za pomocą prostych silników nakładki, pozostaje plikiem opartym na obrazie. Nasz zaawansowany tłumacz PDF z OCR wstawia za renderowanymi znakami aktywną niewidoczną warstwę tekstu, dzięki czemu końcowy zlokalizowany PDF jest w pełni przeszukiwalny i zaznaczalny.
Jak silnik PDF radzi sobie ze złożonymi sąsiadującymi układami kolumn?
Silnik uruchamia model analizy układu, który identyfikuje pionowe dzielniki stron, granice obrazów i strefy bloków. Strukturyzuje tekst w logiczne drzewo, zanim wyśle akapity do modelu tłumaczenia, i zapewnia, że kolumny są tłumaczone jako spójne pojedyncze przepływy, a nie zlewane poziomo.
Co się stanie, jeśli język docelowy nie zmieści się w pierwotnych komórkach tabel?
Rozszerzanie tekstu to częsty problem przy tłumaczeniu z angielskiego na języki europejskie. Silnik tłumaczenia dynamicznie zmniejsza rozmiar czcionki (algorytmami automatycznego dopasowania) lub zawija wiersze wewnątrz granic komórek, aby zachować idealne wyrównanie tabel.
Jak mogę przetłumaczyć zeskanowany PDF chroniony hasłem?
Nasz system potrzebuje dostępu do danych rastrowych dokumentu, aby uruchomić OCR. Musisz usunąć hasła użytkownika i właściciela z pliku PDF, zanim prześlesz go do tłumaczenia. Sprawdź uprawnienia pliku przed przesłaniem.
Dlaczego niektóre niełacińskie znaki (np. arabskie lub japońskie) pojawiły się jako puste kwadraty?
To błąd przypisywania czcionki, znany jako „tofu”. Występuje, gdy przeglądarce PDF brakuje zgodnej czcionki Unicode. Nasz silnik PDF osadza pasujące czcionki (takie jak Noto Sans Arabic czy Noto Sans CJK) bezpośrednio w pliku, dzięki czemu glify wyświetlają się poprawnie na wszystkich urządzeniach.
Czy istnieje limit stron dla przesyłania zeskanowanych plików PDF?
Limity zależą od Twojego planu subskrypcji. Dla ekstremalnie długich dokumentów zalecamy użycie kontrolek zakresu stron, aby przetłumaczyć plik w logicznych partiach, co przyspiesza przetwarzanie i upraszcza sprawdzanie.
Uwolnij ustrukturyzowane dane z zeskanowanych dokumentów
Pomyślne tłumaczenie zeskanowanych plików PDF wymaga głębokiego zrozumienia struktury dokumentów i rekonstrukcji układu. Standardowa ekstrakcja tekstu usuwa formatowanie, a proste nakładki nie radzą sobie z kolumnami i tabelami.
Łącząc zaawansowaną segmentację układu OCR, kontekstowe LLM i precyzyjne osadzanie czcionek zastępczych, możesz tworzyć wysoce czytelne, profesjonalne i przeszukiwalne przetłumaczone pliki PDF, które szanują pierwotną hierarchię projektu.